Машинное обучение и большие данные (Р)
Задания ниже — официальные файлы «Абилимпикс» (источник: abilympics-russia.ru), разложенные по категориям. Решения написаны по тексту задания, регламенту и критериям оценки; в них указано, что именно проверяет эксперт.
Школьник
14–16 лет, базовый уровень заданияВ официальном файле категории не разделены отдельными разделами — приводим задание целиком; различия по категориям смотрите в таблице модулей.
Пошаговое решение
Задание категории «Школьники» — полный цикл работы с данными за 4 часа: три модуля по одному часу двадцати минут; каждый следующий опирается на результат предыдущего. В модуле А вы извлекаете таблицу из выданного источника, описываете структуру, разбираетесь с пропусками и типами, масштабируете количественные признаки, кодируете категориальные и сохраняете датафрейм. В модуле В считаете распределения и описательные статистики, строите матрицу корреляций, отвечаете на частные вопросы работодателя и оформляете отчёт с графиками. В модуле С делите данные на обучающую и проверочную части, обучаете заданную модель, считаете метрики и сохраняете её. Баллы: 35 за модуль А, 40 за модуль В, 25 за модуль С. Тридцать процентов задания меняются на площадке: другой источник, другие вопросы, другая задача модели, поэтому важнее умение осмотреть данные и построить код заново, чем выученный датасет.
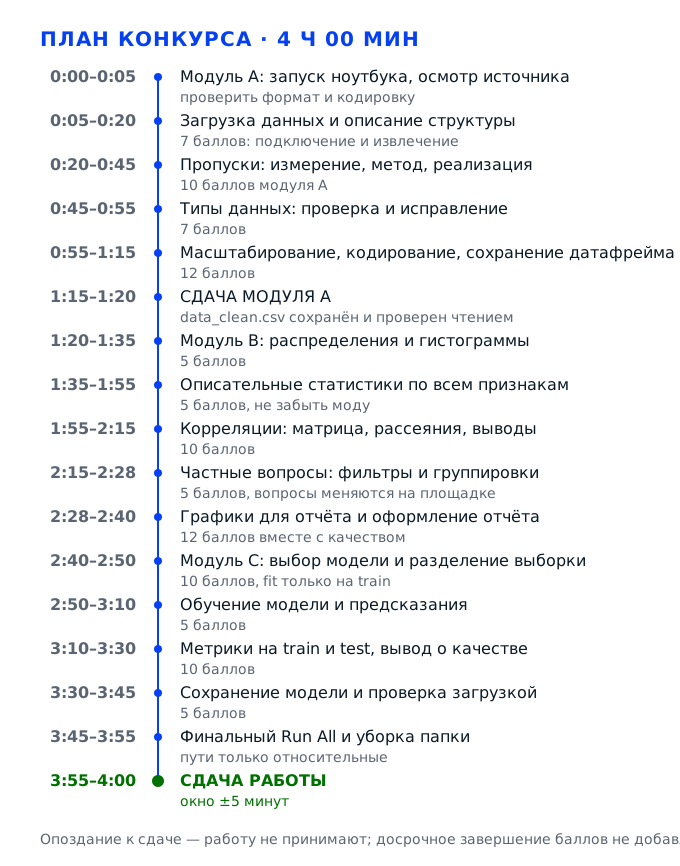
Задача 1. Развернуть рабочую среду и извлечь данные из источникаМодуль А · 35 баллов · 1 ч 20 мин
Модуль начинается не с кода модели, а с двух вещей, которые дают первые семь баллов: подключение к источнику (2 балла) и собственно извлечённый набор данных (5 баллов). Пока данные не загружены и не описаны, остальные пункты модуля А физически не оцениваются, потому что оценивать нечего. Поэтому первая задача — аккуратно открыть то, что выдано, понять формат, загрузить без потерь строк и честно описать, что за признаки лежат в таблице.
Действие 1.1. Подготовить ноутбук и папку работы
Шаг 1.1.1
Создаём в своей папке на площадке каталог с именем по фамилии и номеру участника и внутри него рабочий файл ноутбука, например solution.ipynb, а рядом папку data с выданными файлами. В первой ячейке пишем импорты: pandas, numpy, matplotlib.pyplot, seaborn и заготовку sklearn, затем одну строку с фиксированным зерном случайности RANDOM_STATE = 42. Во второй ячейке выводим версии библиотек через pandas.__version__, numpy.__version__ и sklearn.__version__, чтобы было видно, на чём считали.
Подключение к источнику и извлечение данных — первые семь баллов модуля А, но проверяются они только по исполняемому коду: если ноутбук не запускается сверху вниз, эксперт не увидит ни загрузки, ни обработки. Фиксированное зерно нужно потому, что разделение выборки в модуле С при другом зерне даст другие метрики, и повторная проверка не совпадёт с вашим отчётом.
Выполняем Kernel — Restart and Run All. Все ячейки проходят без красных ошибок, в выводе видны три версии библиотек и нет предупреждений о том, что переменная не определена. Файл ноутбука лежит в собственной папке, а не в корне диска.
Работа в одном огромном скрипте без ячеек и без перезапуска ядра: часть переменных осталась от старых экспериментов, код в чистом виде не работает, и на проверке эксперт видит ошибку там, где у вас на экране всё считалось.
Эксперт открывает ноутбук и пролистывает первые ячейки: есть ли импорты, задано ли зерно, читается ли структура работы сверху вниз без перескоков. Смотрит и на наличие итоговой ячейки.
Шаг 1.1.2
Смотрим, что лежит в папке с данными: выводим os.listdir, размер каждого файла в килобайтах и первые пять строк сырым текстом, без pandas, через open с явной кодировкой. Так сразу видно разделитель (запятая, точка с запятой или табуляция), десятичный разделитель, наличие строки заголовков, кавычки вокруг текстовых полей и лишние пустые строки в конце файла.
Тридцать процентов задания меняются на площадке, и меняется как раз источник: формат файла и набор признаков. Поэтому знакомство с файлом идёт до кода загрузки, а не после: параметры чтения выбираются по факту, а не по привычке с тренировки. Ошибка в разделителе стоит пяти баллов за извлечение данных, потому что таблица приезжает одной колонкой.
В выводе видно от трёх до пяти строк данных, число полей в каждой строке одинаково, заголовки на месте, разделитель определён однозначно. Если строки заканчиваются лишним пустым полем, значит в конце файла есть разделитель — это запомним.
Сразу вызвать pd.read_csv без параметров на файле с точкой с запятой: получается один столбец с длинными именами, дальше все расчёты идут по мусору, а время на переделку съедает половину модуля А. Проверять формат на глаз — та же ошибка.
Смотрит, есть ли в ноутбуке этап осмотра источника: он видит разницу между участником, который читает данные осознанно, и тем, кто вставил готовый шаблон.
Действие 1.2. Загрузить данные без потерь
Шаг 1.2.1
Пишем загрузку в два приёма. Сначала пробное чтение с nrows=5 и всеми явными параметрами: sep, encoding, decimal, thousands, а также dtype=str, чтобы pandas не превратил коды и почтовые индексы в числа. Убедившись, что колонки разошлись правильно, читаем файл целиком тем же набором параметров и сохраняем в переменную df. Имя переменной держим одно на весь ноутбук.
Явные параметры — это и есть подключение к источнику, за которое дают 2 балла, и страховка от тихих потерь: при dtype=str ни одна ведущая цифра не исчезнет, а разделитель тысяч не превратит число в текст. Для json вместо read_csv берём pd.read_json с параметром orient, соответствующим структуре: записи, столбцы или значения.
Сравниваем число строк из пробного чтения и из полного: оно должно совпадать по структуре колонок. df.shape выдаёт осмысленные числа, список df.columns совпадает с заголовками из файла, первые строки совпадают с тем, что видели при осмотре.
Читать без dtype и потом обнаружить, что артикул 007 превратился в 7, а дата стала числом дней от 1970 года. Вторая ошибка — забыть про encoding и получить кракозябры в русских названиях категорий. Третья ошибка — читать файл с параметрами, скопированными из чужого ноутбука.
Проверяет, что df создан кодом с параметрами, а не вставлен через копирование таблицы, и что участник может объяснить каждый параметр чтения. Отдельно спрашивает, почему выбран такой разделитель и такая кодировка.
Шаг 1.2.2
Проверяем целостность загруженного: df.info() для типов и заполненности, df.head(5) и df.tail(5) на предмет служебных строк вроде «Итого» в конце, df.duplicated().sum() для полных дублей и df.duplicated(subset=[ключевой столбец]).sum() для дублей по идентификатору. Отдельно смотрим, нет ли строк, где все значения пустые. Достаточно первых и последних десяти строк.
Строка «Итого» в конце файла — классика учебных выгрузок: она попадает в данные как запись и портит и статистики, и обучение. Дубли по идентификатору означают, что источник собирался из нескольких частей, и это надо либо честно удалить, либо объяснить в отчёте. Пять баллов за извлечение данных ставятся за набор, а не за файл, поэтому чистота строк входит в оценку.
В df.tail нет строк с текстом в числовых колонках, число полных дублей выведено числом и осознанно, df.shape после очистки изменился только на удалённые строки, индекс пересобран через reset_index(drop=True).
Оставить итоговую строку: среднее и дисперсия считаются по ней же, а в модуле С модель учится предсказывать сумму всех строк. Удалить молча половину данных, не записав в отчёт, тоже плохо — эксперт сверяет число строк.
Сравнивает число строк в вашем df с числом строк в исходном файле и смотрит, объяснено ли расхождение в markdown-ячейке. При удалении строк ждёт в отчёте фразы о причине и остатке.
Действие 1.3. Описать структуру набора данных
Шаг 1.3.1
Собираем таблицу-описание признаков: имя столбца, смысл по-русски, тип по смыслу (количественный непрерывный, количественный дискретный, порядковый, номинальный, дата, идентификатор), пример значения, диапазон или перечень значений, есть ли пропуски и сколько. Удобно собрать это в DataFrame из списка словарей и вывести его в ноутбуке, а рядом написать вывод в три-четыре предложения.
Описание структуры — отдельные 3 балла, и это не формальность: без него нельзя обосновать ни метод заполнения пропусков, ни выбор кодирования категорий, ни отбор признаков для модели. Эксперт по этой таблице проверяет, понимает ли участник, что означает каждый столбец, а не просто перечислил названия.
Число строк в описании равно числу столбцов в df. Для каждого количественного признака указан диапазон, для каждого категориального — перечень значений, для идентификатора явно написано, что он не является признаком.
Ограничиться выводом df.info() и назвать это описанием: там нет смысла признаков, и эксперт снимает баллы за структуру. Вторая ошибка — отнести код категории к количественным признакам и потом считать по нему среднее.
Читает таблицу описания и задаёт один вопрос по любому столбцу: что это и как использовать. Ответ должен быть без паузы. Путаница в назначении столбца читается как формальное описание.
Шаг 1.3.2
Определяем целевую переменную и тип задачи. Если в задании сказано предсказать число (цену, количество, срок) — это регрессия, если класс или метку (купит или нет, тип объекта, категорию качества) — классификация. Записываем в markdown-ячейку одной строкой: целевой признак такой-то, задача регрессия, потому что значение непрерывное и измеряется в таких-то единицах, остальные столбцы — признаки.
От типа задачи зависит всё в модуле С: алгоритм, метрики и способ проверки. Ошибка на этом шаге уносит 25 баллов целиком, потому что модель обучается не на ту задачу, а метрики считаются неприменимые. Тридцать процентов изменений касаются как раз формулировки частной задачи, поэтому тип определяется по заданию, а не по памяти.
Записанная формулировка совпадает с текстом задания, единицы измерения целевого признака названы, число уникальных значений целевого признака проверено: непрерывное значение с сотнями уникальных — регрессия, пять-десять классов — классификация.
Решать классификацию там, где нужна регрессия, потому что целевой признак записан целыми числами: accuracy по такой задаче выглядит прилично, но задание не выполнено и метрики не те. В модуле С это видно по абсурдной accuracy на непрерывной цели.
Сверяет вашу формулировку с заданием и смотрит, одинаково ли она звучит в модуле А, в отчёте модуля В и в обосновании выбора модели. Вопрос про единицы измерения задаётся почти всегда.
Задача 2. Разобраться с пропусками и привести типы данныхМодуль А · 35 баллов · 1 ч 20 мин
Пропуски и типы — самый частый источник тихих провалов на этой компетенции: код работает, числа считаются, а результат бессмысленный. Здесь разыгрывается десять баллов: три за вывод о наличии пропусков и выбранный метод (эта часть оценивается экспертом), три за само решение проблемы, три за определение типов и четыре за их исправление. Кроме того, любая ошибка здесь переносится в модуль В и С, потому что испорченный датафрейм вы сохраняете и передаёте дальше.
Действие 2.1. Найти и классифицировать пропуски
Шаг 2.1.1
Считаем пропуски тремя срезами: по столбцам через df.isna().sum(), в процентах от числа строк через деление на len(df) и умножение на сто с округлением до одного знака, и по строкам через df.isna().sum(axis=1), чтобы увидеть, есть ли записи, где пусто почти всё. Результат выводим таблицей, отсортированной по убыванию доли пропусков, чтобы проблемные столбцы были сверху.
Без этого среза невозможно ни выбрать метод, ни обосновать его. Пропуски в 0,5 процента и пропуски в 45 процентов требуют разных решений, а строки, где пусто девять полей из двенадцати, обычно удаляются целиком. Три балла за вывод о пропусках ставятся именно за то, что участник сначала измерил, а потом решил.
Сумма пропусков по столбцам совпадает с суммой по строкам. Для каждого столбца с пропусками указана доля в процентах, общий процент посчитан от всех ячеек. Общее число пропущенных ячеек и их доля от всех ячеек выводятся одной строкой.
Проверить только df.isnull().any() и получить ответ «да, есть»: без объёма пропусков метод не обосновать, и оценочные три балла уходят. Молча удалить все строки с любым пропуском — тоже потеря: таблица может уменьшиться на треть вместе с редкими категориями.
Смотрит на выведенную таблицу и на то, упомянуты ли в выводах конкретные числа и названия столбцов. Ему важно увидеть, что участник сначала измерил объём проблемы, а решение принял после измерения.
Шаг 2.1.2
Отдельно ищем замаскированные пропуски, которых pandas не видит: прочерк, пустая строка, слово «нет данных», «н/д», значение -1 или 999 в возрасте, нули в столбце, где ноль невозможен, и пустая дата. Проверяем через value_counts по каждому подозрительному столбцу, а также ищем значения на границах: минимальное и максимальное слишком подозрительны, если равны -1 или 999. Найденное приводим к настоящему NaN тем же методом, который потом запишем в отчёт.
Это различие отделяет оценку на 3 балла от оценки выше: настоящий пропуск pandas покажет сам, а замаскированный виден только внимательному. Если -1 останется в данных, среднее поедет вниз, а модель в модуле С выучит, что минус единица — это отдельный, очень «плохой» возраст.
После замены df.isna().sum() вырос ровно на число найденных подделок, а value_counts по столбцу больше не содержит -1 и 999. В отчёте перечислены все найденные обозначения пропусков. Число строк при замене обозначений не должно измениться.
Оставить -1 и 999 в числовых столбцах: гистограмма в модуле В покажет ложный выброс, масштабирование сожмёт настоящие значения, а метрики модели будут загадочно плохими. Замаскированные пропуски опаснее тем, что не видны ни в info(), ни в isna().
Смотрит, искал ли участник пропуски глазами по значениям, а не только функциями: это заметно по ячейкам с value_counts и по упоминанию в выводах. Ценится, если в отчёте перечислены все найденные обозначения пропусков.
Шаг 2.1.3
Пишем вывод в markdown: сколько пропусков, в каких столбцах, какого они типа — случайные, зависящие от другого признака или структурные (например, поле заполняется только для одного вида записей), и какой метод выбран для каждого столбца, с одной фразой обоснования. Формулируем коротко и по делу, например: в столбце площадь пропущено 8 процентов, распределение скошено вправо, поэтому заполняем медианой, а не средним.
Три балла за этот пункт в критериях помечены как оценочные: эксперту важно не столько число пропусков, сколько связка «увидел — обосновал — сделал». Обоснование потом пригодится в защите: на вопрос «почему медиана» ответ должен быть готов заранее. Формулировка должна произноситься вслух без подготовки.
В выводе названы столбцы и доли, метод указан для каждого столбца отдельно, обоснование опирается на форму распределения или на долю пропусков, а не на «так принято». Хорошо, когда в выводе есть число: пропущено 8 процентов, медиана устойчива к выбросам.
Написать «пропуски заполнены средним» без единого числа: оценочные баллы за вывод снимаются полностью, даже если код заполнения правильный. Ещё хуже — заполнить всё одной строкой на датафрейм и написать, что метод выбран осознанно.
Читает вывод до кода и сверяет с ним фактическую реализацию: совпадает ли метод в тексте с тем, что вызывается в ячейке. Обещанный в тексте индикатор пропуска должен быть в таблице отдельным столбцом.
Действие 2.2. Решить проблему пропусков
Шаг 2.2.1
Реализуем выбранные методы по столбцам, а не одной строкой на весь датафрейм. Числовые заполняем медианой через df[col].fillna(df[col].median()), потому что медиана не боится выбросов; категориальные — модой или отдельной категорией «неизвестно», если пропуск сам по себе информативен; строки с пропуском в целевом признаке удаляем, обучать модель на неизвестном ответе нельзя. Заполненные значения медиан сохраняем в словарь, чтобы потом применить те же числа к проверочной выборке.
Решение проблемы пропусков — 3 балла, и они ставятся за исполнение, а не за рассуждение. Сохранение медиан в словарь нужно для аккуратности: если в модуле С делить данные после заполнения, медиана считается по всей таблице и информация из проверочной части просачивается в обучение — это называют утечкой данных.
df.isna().sum() по всем столбцам равно нулю, форма датафрейма уменьшилась только на число удалённых строк с пустой целью, словарь с заполненными значениями выведен и содержит столько пар, сколько столбцов заполнялось.
Заполнить вообще все пропуски нулём: в количественных признаках ноль сдвигает среднее и создаёт ложную связь с целью, а в категориальных появляется несуществующая категория, которая потом съедает балл за кодирование.
Сверяет код заполнения с обоснованием и проверяет, не осталось ли столбцов, где пропуски просто исчезли после удаления строк без объяснения. Отдельно проверяет, что целевую переменную заполнение не тронуло.
Шаг 2.2.2
Проверяем, что заполнение не исказило картину: сравниваем среднее, медиану и стандартное отклонение до и после заполнения по каждому столбцу, где были пропуски, и выводим разницу в процентах. Если доля пропусков была больше десяти процентов, дополнительно строим две гистограммы рядом — до и после — и смотрим, не появилось ли искусственного пика на значении заполнения.
Заполнение медианой при большой доле пропусков сжимает дисперсию и создаёт пик в середине распределения, что видно в модуле В как странная форма. Заметив это сразу, вы успеваете сменить метод или добавить столбец-индикатор пропуска, а не объясняете эксперту артефакт в конце.
Разница среднего до и после в пределах нескольких процентов, стандартное отклонение не упало вдвое, на гистограмме нет узкого столба на медианном значении выше остальных. При небольшой доле пропусков различия в статистиках остаются в пределах процента.
Не проверять эффект заполнения и получить в модуле В бимодальное распределение, которого нет в данных: дальше выводы о связи признаков строятся на артефакте. Правильнее добавить столбец-индикатор пропуска и упомянуть его в описании признаков.
Может попросить показать сравнение до и после: наличие такого вывода читается как взрослый уровень работы. Такой шаг на школьном уровне делают редко, и он поднимает оценку за качество предобработки.
Действие 2.3. Привести типы данных к смыслу признаков
Шаг 2.3.1
Проходим по df.dtypes и для каждого столбца отвечаем на вопрос, совпадает ли машинный тип со смыслом. Типичные несоответствия: числа с пробелом и запятой лежат как object, дата лежит строкой в формате день.месяц.год, булево записано словами «да» и «нет», а код категории (1, 2, 3) записан числом. Все расхождения выписываем в таблицу «столбец — текущий тип — нужный тип — почему».
Определение типов и вывод об их соответствии — 3 балла, исправление — ещё 4. Без исправления не работают ни describe по числам, ни корреляции, ни модель: объектный столбец с числами просто выпадает из расчётов, и вы теряете признаки, не замечая этого.
Для каждого столбца в таблице есть решение, число строк таблицы равно числу столбцов, и столбцов с типом object осталось ровно столько, сколько настоящих текстовых признаков. Идентификаторы остаются в таблице, но помечены как не признаки.
Оставить числа в object и удивляться, что корреляционная матрица пустая или в ней только три столбца. Вторая ошибка — превратить код категории в число и считать по нему среднее, хотя это бессмысленно.
Смотрит на таблицу типов и проверяет, различает ли участник число как величину и число как метку класса. Отдельно проверяются столбцы, где число означает код региона: их нельзя складывать и усреднять.
Шаг 2.3.2
Исправляем типы по одной операции на столбец: убираем пробелы и заменяем запятую на точку, затем pd.to_numeric с errors=coerce, а не с errors=ignore, чтобы видеть проблемные значения как NaN; даты переводим через pd.to_datetime с явным указанием format, иначе pandas угадает неверно и перепутает день с месяцем; слова «да» и «нет» переводим в булев тип через map; коды категорий переводим в category или оставляем номинальными, если порядок не задан.
errors=coerce — ключевая деталь: он превращает нечитаемое значение в пропуск, и вы сразу видите, сколько строк было испорчено в источнике, вместо молчаливого сохранения строки как есть. format в to_datetime защищает от самой дорогой ошибки этой компетенции — перепутанных дня и месяца в датах.
После приведения df.dtypes показывает int64 или float64 для чисел, datetime64 для дат, category или object для меток. Минимум и максимум каждого числового столбца попали в правдоподобный диапазон, даты лежат между разумными годами.
Использовать errors=ignore: строка с дефектом остаётся текстом, столбец не становится числовым, и вы half-столбец теряете. Или привести дату без формата и получить в марте декабрьские записи. Формат даты проверяется на строках, где день больше двенадцати.
Проверяет даты на нескольких строках: день и месяц должны стоять на своих местах, это видно по правдоподобности последовательности. Так же проверяются единицы измерения: рубли и тысячи рублей не должны смешиваться в одном столбце.
Шаг 2.3.3
Сверяем результат: выводим df.info() и отдельно число новых пропусков, появившихся после приведения типов, сравниваем с числом до операции. Для каждого исправленного столбца печатаем три значения до и после — минимум, максимум и медиану, — чтобы убедиться, что смысл не потерян. Найденные при этом дефекты записываем в отчёт одной строкой на столбец.
Четыре балла за исправление типов ставятся по факту: столбец должен быть исправлен целиком, а не наполовину. Новые пропуски после coerce — это честная информация о качестве источника, и она украшает отчёт, а не портит его, если объяснена. Отчёт о дефектах источника — часть работы с данными.
Число новых NaN объяснено по каждому столбцу, медиана и максимум после приведения совпадают с ожидаемым порядком величин, ни одна дата не уехала за пределы двадцатилетнего окна. Если после приведения появилось много новых пропусков, об этом пишется отдельная строка.
Не заметить, что после coerce пропало тридцать процентов значений столбца: модель в модуле С обучится на остатке и покажет метрики, которые невозможно объяснить. Тогда же выясняется, что часть строк потеряна безвозвратно.
Сверяет число строк и заполненность столбцов до и после: по этим числам видно, сколько данных реально дошло до модели. Он же сверяет число строк в df с числом строк в исходном файле.
Задача 3. Масштабировать количественные и закодировать категориальные признакиМодуль А · 35 баллов · 1 ч 20 мин
Здесь решается, доедет ли таблица до модели в пригодном виде. Десять баллов модуля А приходятся ровно на этот шаг: пять за определённые шкалы и выполненное масштабирование количественных признаков, пять за подсчёт уникальных значений категориальных признаков и реализованный переход к числам. Плюс два балла за сохранение предобработанного датафрейма в требуемом формате. Одновременно это последняя возможность заметить выбросы и бессмысленные значения до того, как они попадут в корреляции и в обучение.
Действие 3.1. Определить шкалы и масштабировать
Шаг 3.1.1
Для каждого количественного признака выводим минимум, максимум, среднее, медиану и квартили через df[num_cols].describe().round(2) и рядом — шкалу, в которой признак измеряется: рубли, годы, метры, штуки, проценты. Проверяем границы на правдоподобность: возраст вне диапазона 6–100, цена не выше нуля, площадь больше тысячи квадратных метров в обычной квартирной выгрузке — всё это дефекты источника.
Пять баллов ставятся за определённые шкалы изменения, и это не про красоту отчёта: признак с разбросом от 0 до 1 и признак с разбросом от 0 до миллиона будут обрабатываться моделью неравноправно, а выброс в одном столбце перекосит масштабирование для всех остальных. Дефекты диапазона, найденные сейчас, дешевле исправить, чем объяснять в модуле С.
Для каждого количественного признака в отчёте есть единица измерения и допустимый диапазон, и ни одно фактическое значение за его пределы не выходит — либо выходит, но с записью о том, что сделано. Единицы измерения стоят рядом с именем признака в таблице описания.
Пропустить возраст 210 лет и цену минус три рубля: после масштабирования они дадут крайние точки, гистограммы сожмутся в один столб, а корреляция с целью упадёт из-за двух строк мусора. Проверка границ занимает минуту и почти всегда что-то находит.
Смотрит, названы ли единицы измерения: без них невозможно понять, что означает коэффициент модели в модуле С. Без единиц измерения коэффициент модели читается как плюс 0,3 чего-то.
Шаг 3.1.2
Ищем выбросы по правилу межквартильного размаха: считаем Q1 и Q3, границы Q1 минус 1,5 на размах и Q3 плюс 1,5 на размах, выводим число значений за границами и их долю в процентах. Затем решаем по каждому столбцу: оставить как есть, если это реальные дорогие объекты, или ограничить сверху значением 99-го процентиля методом clip, если это ошибка ввода.
Отдельного балла за выбросы в критериях нет, но они напрямую влияют на три пункта: масштабирование, корреляции и метрику модели. Обрезка по 99-му процентилю сохраняет все строки и меняет несколько значений — это самый безопасный вариант, когда причина выброса неизвестна и удалять данные страшно.
После решения по каждому столбцу число значений за границами либо равно нулю, либо объяснено в отчёте. Максимум признака стал правдоподобным, число строк не изменилось, если применялось clip. Если строки удалялись, их число записано в отчёт.
Удалить все строки с выбросами по всем столбцам сразу: можно потерять пятую часть данных, и модель обучится на усечённой реальности, а в отчёте не будет объяснения. Безопаснее ограничить значения сверху и сохранить все строки.
Спрашивает, почему выброс оставлен или удалён: приемлемы оба ответа, неприемлемо отсутствие ответа. Отсутствие решения по выбросам читается как пропущенный этап исследования.
Шаг 3.1.3
Масштабируем количественные признаки: создаём StandardScaler для признаков с близким к нормальному распределением и MinMaxScaler для тех, где важен диапазон. Обучаем scaler на обучающей части через fit_transform и применяем к проверочной через transform, а столбцы собираем обратно в DataFrame с теми же именами и индексом. Если моделью выбрано дерево решений, масштабирование не обязательно — тогда в отчёте пишем одну фразу о том, почему оно не выполнялось.
Пять баллов за масштабирование и ровно та же логика, что с медианой: параметры масштаба считаются на обучении и переносятся на проверку, иначе тест видит статистику проверочной выборки. Обратная сборка в DataFrame нужна, чтобы не потерять имена столбцов — без них отчёт и важность признаков превращаются в набор безымянных чисел.
После масштабирования среднее по каждому обученному столбцу близко к нулю, стандартное отклонение близко к единице, имена столбцов сохранены, форма таблицы та же, что до масштабирования. Минимум и максимум до и после масштабирования не меняются.
Применить fit_transform ко всей таблице целиком до разделения: это утечка, и метрика на проверке получается красивее реальной. Вторая ошибка — масштабировать целевую переменную в регрессии и потом не вернуть её в исходные единицы.
Проверяет, где вызван fit: на train или на всём наборе. Это одна из самых частых ловушек, на которую смотрят специально. Если масштабирование не выполнялось, в отчёте есть фраза об этом с указанием модели.
Действие 3.2. Перевести категориальные признаки в числа
Шаг 3.2.1
По каждому номинальному и порядковому признаку считаем число уникальных значений через df[col].nunique() и выводим сами значения с частотами через value_counts. Решаем по правилу: до пятнадцати уникальных значений — one-hot кодирование; больше пятнадцати — либо объединяем редкие в категорию «прочее» по порогу в один процент, либо, если признак порядковый, задаём числовой порядок явным словарём.
Пять баллов за пункт требуют именно подсчёта уникальных значений и осознанного выбора метода. One-hot на столбце с двумястами уникальных значений даст двести новых столбцов, модель обучится на шуме, а таблица раздуется так, что её станет трудно читать. Порядковый признак, закодированный one-hot, теряет смысл порядка.
Для каждого категориального признака в отчёте есть число уникальных значений, выбранный метод и одна фраза обоснования. Столбцов с числом уникальных больше пятнадцати, закодированных one-hot без объединения редких, не осталось.
Применить get_dummies ко всей таблице без разбора: появляется триста столбцов, в модели обучается триста коэффициентов на сотню строк, и метрики становятся случайными. Отдельно плохо объединять редкие категории, не посчитав их частоты.
Смотрит на список категорий и на обоснование: видно, разбирался ли участник в смысле признака или применил одну функцию ко всему. Смотрит и на то, что порядок в порядковом признаке сохранён.
Шаг 3.2.2
Реализуем переход. Для one-hot используем pd.get_dummies с параметром drop_first=False, чтобы каждая категория имела свой столбец и коэффициенты читались по отдельности, и с dtype=int, чтобы вместо True и False были единицы и нули. Для порядкового признака пишем словарь соответствия вида «низкий» — 1, «средний» — 2, «высокий» — 3 и применяем map. Имена новых столбцов делаем читаемыми: имя признака плюс подчёркивание плюс значение категории.
Имена столбцов после кодирования нужны трижды: в отчёте модуля В, при отборе признаков и при объяснении важности в модуле С. Без читаемых имён все три шага превращаются в перебор безымянных признаков, и вы не сможете сказать, какой фактор сильнее всего влияет на цель.
Число столбцов после кодирования равно исходному числу плюс число категорий минус число закодированных признаков. Сумма one-hot столбцов одного признака по каждой строке равна единице. В таблице нет столбцов с типом object.
Оставить в таблице столбец с текстом и передать его в модель: scikit-learn выдаст ошибку о невозможности преобразовать строку в число уже в модуле С, и время на исправление пойдёт из часов, отведённых на модель.
Проверяет имена и число столбцов: раздутая таблица из сотен бинарных столбцов читается как отсутствие разбора. Если столбцов стало больше двухсот, пора объединять редкие категории, а не кодировать дальше.
Шаг 3.2.3
Проверяем результат кодирования: выводим форму таблицы до и после, df.select_dtypes(include=[object]).columns для контроля, что текстовых столбцов не осталось, и три первые строки целиком, чтобы глазами увидеть единицы и нули на своих местах. Отдельно проверяем, что категория «неизвестно», добавленная при заполнении пропусков, получила свой столбец и не слилась с реальной категорией.
Проверка занимает минуту, а спасает от двух типичных провалов: перепутанных уровней после get_dummies на объединённых данных и потерянной категории «неизвестно». Оба дефекта не видны по коду и обнаруживаются только в метриках, когда уже поздно. Проверка занимает минуту и почти всегда что-то находит.
df.shape после кодирования объяснимо больше, select_dtypes по object пуст, сумма единиц в блоке one-hot по каждой строке равна единице, категория «неизвестно» присутствует отдельным столбцом. Число строк при кодировании не меняется.
Кодировать train и test по отдельности: в них получается разный набор столбцов, и модель при применении к тесту падает с ошибкой о несовпадении признаков. Правильно обучать кодировщик на train и применять к test: наборы столбцов совпадут по построению.
Сверяет набор столбцов обучающей и проверочной части — это проверяется автоматически в большинстве решений. На несовпадении столбцов падает большинство решений, проверка автоматизируется.
Действие 3.3. Сохранить предобработанный датафрейм
Шаг 3.3.1
Сохраняем результат модуля А отдельным файлом с понятным именем, например data_clean.csv, через df.to_csv(path, index=False, encoding=utf-8). Если в таблице есть даты, дополнительно сохраняем версию в pickle через to_pickle, потому что csv не хранит типы и при повторном чтении дата снова станет строкой. Путь к файлу задаём относительным, от папки проекта, чтобы ноутбук открывался на любой машине.
Два балла за сохранение датафрейма в требуемом формате — формально небольшие, но именно этот файл подтверждает, что модуль А завершён. index=False обязателен: без него в файл уезжает безымянный индекс и при чтении появляется лишний столбец, который потом путают с признаком.
Файл создан по ожидаемому пути, его размер правдоподобен, число строк в файле равно числу строк в df, а первая строка содержит имена столбцов, а не индекс. В файле не должно быть столбца Unnamed, который появляется при сохранении индекса.
Сохранить с index=True и потом считать безымянный столбец признаком: модель может выучить порядок строк, а на новых данных покажет метрику хуже случайной. Вторая ошибка — сохранять только xlsx: формат медленнее и теряет часть типов.
Открывает файл и проверяет, что заголовки читаемые, а данные не в одну колонку. Для него важно, что сохранён предобработанный набор: пропуски заполнены, категории закодированы.
Шаг 3.3.2
Проверяем сохранение обратным чтением: pd.read_csv с тем же набором параметров, сравнение формы, списка столбцов и суммы пропусков с исходным df. Дополнительно сверяем сумму по одному числовому столбцу до и после сохранения — она должна совпасть с точностью до копеек, а не «примерно». Если расхождение есть, ищем причину в параметрах записи, а не в данных: обычно дело в разделителе.
Обратное чтение — это тот же приём, которым эксперт проверяет работу: если файл не читается или читается криво, модуль А не принят независимо от кода в ноутбуке. Совпадение суммы подтверждает, что при записи не потерялась точность и не сдвинулись разделители.
Форма совпадает, списки столбцов идентичны, сумма пропусков равна нулю, контрольная сумма по числовому столбцу совпадает до второго знака. Полезно открыть файл в новой ячейке с чистым ядром, чтобы проверить чтение без старых переменных.
Сохранить с разделителем по умолчанию и прочитать с другим: получается один столбец, и вся работа модуля А обнуляется на ровном месте. Если нужен только pickle, читаемую версию всё равно стоит оставить: часть проверок делается по csv.
Проверяет файл именно чтением, а не просмотром в блокноте: так видно то же, что увидит проверяющая программа. Файл, который в Excel выглядит одной колонкой, читается как ошибка сохранения.
Задача 4. Исследовать распределения, статистики и корреляцииМодуль В · 40 баллов · 1 ч 20 мин
Модуль В — самый дорогой: 40 баллов, и пятнадцать из них приходятся на распределения, описательные статистики и корреляции. Здесь вы перестаёте приводить данные в порядок и начинаете отвечать на вопросы о них. Правило простое: каждый график делается для конкретного вывода, а не для красоты, и под каждым графиком в отчёте есть фраза о том, что он показывает. Графики без вывода и выводы без графиков в этом модуле не считаются выполненными.
Действие 4.1. Посмотреть распределения признаков
Шаг 4.1.1
Строим гистограммы по всем количественным признакам в сетке: plt.subplots с числом строк и столбцов под число признаков, bins=30, у каждой панели свой заголовок с именем признака и единицей измерения, подписи осей x и y. figsize ставим таким, чтобы подписи не наезжали друг на друга, например 14 на 3 умножить на число признаков, и завершаем plt.tight_layout().
Пять баллов за исследование распределения ставятся за графики на все признаки, а не на два любимых. Именно здесь видно, что часть признаков скошена вправо и требует логарифма, что есть нулевая инфляция и что один признак почти константа — и всё это меняет решения в модуле С.
Число панелей равно числу количественных признаков, у каждой есть заголовок и подписи осей, ни одна панель не обрезана. Ни один признак не пропущен. Если у признака всего несколько уникальных значений, гистограмма заменяется столбиковой диаграммой частот.
Построить один общий график по всем столбцам сразу: получается каша с разными масштабами, из которой нельзя сделать вывод, и балл снимается за качество графиков. Второй провал — подписи, наехавшие друг на друга: из графика нельзя прочитать значения.
Считает число графиков и сверяет с числом признаков: пропуск виден сразу. Он же смотрит на подписи осей: у признака в рублях должна быть подпись в рублях, а не просто значение.
Шаг 4.1.2
Для скошенных признаков и для связи с целевой строим ящики с усами: sns.boxplot по категориальному признаку и целевой переменной, sns.histplot с параметром kde=True для формы. Если разброс превышает два порядка, переходим на логарифмическую шкалу через plt.xscale или np.log1p и подписываем ось как логарифм величины, а не как саму величину. Логарифм берём через log1p, чтобы не терять нулевые значения.
Ящик с усами показывает медиану, квартили и выбросы в одном кадре и позволяет сравнить группы между собой — это прямой мост к частным вопросам модуля В. Логарифмическая шкала нужна, чтобы форма распределения стала видимой: на линейной шкале скошенный признак выглядит одним столбом у нуля.
На графике видно медиану и размах по каждой группе, выбросы отмечены отдельными точками, ось подписана корректно с учётом преобразования, число групп совпадает с числом категорий. Порядок групп на графике должен совпадать с порядком в таблице группировки.
Подписать логарифмированную ось исходными числами: читатель видит несуществующие значения, а эксперт читает это как непонимание преобразования. Проверять преобразование нужно на двух-трёх значениях вручную, сравнив с исходными.
Смотрит, различает ли участник выброс и реальный край распределения по форме графика. Отдельно отмечает, подписана ли ось с учётом логарифма и понятно ли из подписи, что шкала нелинейная.
Шаг 4.1.3
Записываем вывод по форме каждого распределения одной строкой на признак: симметричное, скошено вправо, скошено влево, бимодальное, с нулевой инфляцией, почти константа. Указываем, что из этого следует для дальнейшей работы: нужен логарифм, нужен непараметрический критерий, признак можно исключить как бесполезный. Признак, у которого больше 95 процентов значений совпадают, помечаем как кандидат на удаление.
Выводы — это то, за что реально ставят баллы: сам график без интерпретации оценивается как незавершённая работа. Кроме того, эти записи потом почти дословно переходят в отчёт и в защиту, поэтому экономить на них невыгодно. Скошенность, замеченная здесь, объясняет выбор медианы в модуле А.
Число выводов равно числу признаков, в каждом названа форма и следствие, ни один вывод не сводится к фразе «распределение нормальное» без проверки. Если признак почти константа, это должно быть написано прямо, а не спрятано в общей фразе.
Написать «все признаки распределены нормально» по умолчанию: на скошенных данных это утверждение неверно, и дальше все выводы о среднем оказываются смещёнными. Вывод про нормальность подтверждается хотя бы грубой проверкой симметрии по квартилям.
Сверяет вывод с графиком: если на картинке явная скошенность, а в тексте «нормальное», балл за интерпретацию снимается. Он сверяет два-три вывода с графиками выборочно и по ним судит об остальных.
Действие 4.2. Вычислить описательные статистики
Шаг 4.2.1
Собираем таблицу описательных характеристик по всем количественным признакам: минимум, максимум, среднее, медиана, мода, дисперсия и стандартное отклонение. Считаем через df[num].agg с явным списком функций плюс отдельный вызов df[num].mode().iloc[0] для моды, потому что agg её не поддерживает; результат собираем в DataFrame, округляем до двух знаков и выводим как таблицу отчёта.
Пять баллов за описательные статистики требуют полного набора: в критериях перечислены минимум, максимум, среднее, мода, медиана и дисперсия. Пропуск моды — самая частая потеря этих баллов, потому что её нет в describe по умолчанию и участники про неё забывают.
В таблице шесть строк или шесть столбцов метрик на каждый признак, все значения заполнены, дисперсия не отрицательная, медиана лежит между минимумом и максимумом, мода присутствует для каждого признака.
Ограничиться describe() и потерять моду: балл за статистики снимается частично, хотя работа сделана на девяносто процентов. Мода нужна и в категориальных признаках: для них describe вообще не работает, а частоты нужны.
Сверяет таблицу с перечнем в задании по пунктам: каждой названной характеристике должен соответствовать столбец. Если какой-то характеристики нет, он отмечает это как невыполненный пункт.
Шаг 4.2.2
Интерпретируем таблицу: для каждого признака сравниваем среднее с медианой и записываем, что это значит. Расхождение больше двадцати процентов говорит о скошенности и выбросах, тогда среднее плохо описывает типичное значение и в выводах надо опираться на медиану. Дисперсию переводим в стандартное отклонение и сравниваем с размахом, чтобы проверить, не раздут ли он выбросами.
Оценочная часть баллов за статистики ставится за интерпретацию, а не за вызов функции. Практическая польза тоже прямая: если в отчёте написано «в среднем 42», а медиана 28, эксперт задаст вопрос, и лучше, чтобы ответ был уже в тексте. Проверка занимает две минуты и защищает от неверного вывода в отчёте.
Для каждого признака есть фраза о соотношении среднего и медианы, для двух-трёх ключевых признаков указано, какая характеристика лучше описывает типичное значение и почему. Для двух-трёх признаков указано, какая характеристика лучше описывает типичное значение.
Считать только среднее и делать выводы по нему: при скошенном распределении вывод оказывается неверным, а работа формально выполнена. Вторая ошибка — считать дисперсию по категориальному признаку: у меток класса нет разброса.
Спрашивает, чем среднее отличается от медианы в ваших данных, и ждёт ответа с числами из таблицы. Он может попросить назвать признак с самой большой дисперсией и объяснить, почему.
Действие 4.3. Исследовать корреляции
Шаг 4.3.1
Считаем матрицу корреляций по числовым признакам через df[num].corr(method=pearson), округляем до двух знаков и строим тепловую карту: sns.heatmap с annot=True, fmt=равно точка два, cmap с расходящейся шкалой, vmin=-1 и vmax=1, маска верхнего треугольника через np.triu, чтобы не дублировать пары. Для порядковых признаков и при явной нелинейности дополнительно считаем Спирмена.
Корреляции — десять баллов из сорока: пять за исследование зависимостей и выводы, пять за графики. Фиксированная шкала от минус единицы до единицы обязательна, иначе автоматическая нормировка делает слабые связи яркими и вводит в заблуждение, а расходящаяся палитра позволяет отличить прямую связь от обратной по цвету.
Матрица квадратная, на диагонали единицы, значения лежат в диапазоне от минус единицы до единицы, число строк и столбцов равно числу числовых признаков, шкала цвета подписана. Маска верхнего треугольника должна скрывать дубли пар, а не обнулять значения.
Оставить шкалу по умолчанию: слабые коэффициенты 0,1 выглядят так же ярко, как 0,9, и вывод о сильной связи оказывается ложным. Вторая ошибка — считать корреляцию по категориальным признакам без кодирования: получается мусор.
Смотрит, есть ли на графике подписи коэффициентов и фиксированная шкала — два признака аккуратной работы. Он проверяет, подписаны ли коэффициенты: без чисел тепловая карта читается только качественно.
Шаг 4.3.2
Разбираем коэффициенты: выводим пары признаков с модулем корреляции выше 0,7 отдельным списком, пары с корреляцией с целевой переменной сортируем по убыванию модуля. Для каждой сильной пары решаем, что делать: оставить один из двух признаков, объединить их в один или оставить оба, если связь объяснима по смыслу. Решение записываем в отчёт с указанием коэффициента.
Пять баллов за исследование зависимостей и выводы ставятся за список сильных связей и решения по ним. Мультиколлинеарность не мешает деревьям, но ломает линейную регрессию: коэффициенты становятся неустойчивыми, а важность признаков — противоречивой.
Список пар с коэффициентом выше 0,7 выведен, по каждой паре есть решение, сильнейшие связи с целевой переменной названы с числами и знаком направления. Для каждой пары с сильной связью записано решение: оставить, объединить или убрать признак.
Оставить в модели два признака с корреляцией 0,98 и потом объяснять, почему коэффициенты поменяли знак: связь между признаками искажает вклад каждого. В линейной регрессии это проявляется скачком коэффициентов при добавлении одной строки.
Просит назвать самый сильный предиктор и его коэффициент: ответ должен звучать сразу, без поиска в таблице. Он же смотрит, не остались ли в списке признаки, посчитанные из целевой переменной.
Шаг 4.3.3
Проверяем, что сильная связь не создана выбросами или группой: для двух-трёх сильнейших пар строим диаграмму рассеяния через sns.scatterplot или sns.regplot с линией тренда, подписываем оси и выводим коэффициент прямо в заголовок. Если точки ложатся в две отдельные группы, дополнительно красим их по категориальному признаку через hue. Линию тренда строим только для пар с линейной связью.
Один выброс способен дать коэффициент 0,8 там, где связи нет: без диаграммы рассеяния это не видно. Пять баллов за графики, визуализирующие корреляционные зависимости, ставятся именно за такие графики, а не только за тепловую карту. Такая точка видна только на рассеянии, в матрице она неотличима от закономерности.
Для каждой из двух-трёх пар есть рассеяние с линией тренда, коэффициент в заголовке совпадает с матрицей, форма облака точек соответствует выводу о линейности. Если облако точек изогнуто, в выводе это отмечается отдельно.
Сделать вывод о линейной связи по одному коэффициенту: при нелинейной зависимости Пирсон даёт ноль, и вы отбросите реально важный признак. Рассеяние по двум-трём ключевым парам строится всегда, даже если времени мало.
Смотрит, замечает ли участник нелинейность на графике и упоминает ли её в выводах. Он смотрит на подписи осей и на наличие линии тренда: это признак осознанного выбора графика.
Задача 5. Ответить на частные вопросы и собрать отчётМодуль В · 40 баллов · 1 ч 20 мин
Частные вопросы работодателя — та часть задания, которая меняется на площадке чаще всего, поэтому готового ответа тут быть не может: важно показать, что вы умеете переводить словесную формулировку в фильтр и группировку. За ответы дают 5 баллов, за графики, визуализирующие анализ, ещё 5, за качество графиков 3 и за отчёт 7 баллов вместе с качеством оформления. Отчёт — это единственное, что останется у эксперта после конкурса, поэтому он собирается не в последние пять минут, а по ходу работы.
Действие 5.1. Перевести вопросы в фильтры данных
Шаг 5.1.1
Выписываем вопросы из задания отдельными markdown-ячейками, по одной на вопрос, и под каждым формулируем условие на языке столбцов: какие признаки участвуют, какое сравнение, строгое или нестрогое, нужны ли несколько условий одновременно. Фильтр пишем через маску с явными скобками: df[(df[col] >= a) & (df[col2] != b)], либо через df.query со строкой условия, где названия столбцов без пробелов.
Пять баллов за ответы на частные вопросы ставятся за точные ответы на все вопросы, а не за один. Скобки в маске — источник самой обидной ошибки: без них приоритет операций искажает условие, фильтр получается другим, и число в ответе не сходится с эталонным.
Для каждого вопроса записано условие в тексте и в коде, число строк после фильтра меньше исходного, а на нескольких строках вручную проверено, что они действительно удовлетворяют условию. Число строк после фильтра меньше исходного.
Написать условие через and вместо побитового & и получить ошибку или неверный отбор; вторая ошибка — забыть скобки вокруг каждого сравнения. Правильная запись — каждое сравнение в своих скобках, соединённых побитовым и.
Сверяет число строк и значение ответа со своим эталоном: расхождение видно сразу. Ошибка в скобках всплывает именно на этой сверке, а не в коде. Так вопрос остаётся без балла.
Шаг 5.1.2
Отвечаем числом, а не описанием. Для вопросов вида «сколько», «какая доля», «во сколько раз» выводим одно значение с округлением и подписью единицы: len(sub), len(sub) / len(df) * 100, среднее по отфильтрованным строкам. Ответ записываем в текст отчёта сразу после соответствующей ячейки, формулируя его полным предложением с числом. Ответ должен читаться без обращения к коду.
Ответы на частные вопросы — 5 баллов, и оцениваются они по совпадению с ожидаемым значением. Развёрнутое предложение с числом нужно ещё и потому, что отчёт читает человек: ответ, спрятанный в выводе ячейки, эксперт может не найти и засчитать вопрос неотвеченным.
Число ответов в тексте равно числу вопросов в задании, у каждого числа есть единица измерения и округление, ни один ответ не повторяет вопрос без значения. У каждого ответа указана единица: человек, проценты, рубли или штуки.
Оставить ответ только в выводе кода: при проверке отчёта вопрос считается неотвеченным, даже если расчёт правильный. Вторая ошибка — отвечать на вопрос текстом без числа: эксперт ищет значение и не находит.
Ищет в отчёте явные ответы и сверяет с эталонными числами; за ответ «примерно половина» балл не ставится. Он обращает внимание и на округление: два знака после запятой достаточно.
Действие 5.2. Сгруппировать данные и посчитать групповые значения
Шаг 5.2.1
Строим группировку по нужному признаку через df.groupby(key).agg с явным набором функций: mean, min, max, sum, count. Чтобы столбцы не получились двухуровневыми, задаём имена сразу через именованные агрегации: agg(среднее=('цена', 'mean'), минимум=('цена', 'min')) и так далее. Результат сбрасываем в обычную таблицу через reset_index и округляем. Округление до двух знаков достаточно.
Пункт задания требует именно пяти агрегатов в группах: среднее, минимум, максимум, сумма и количество. Именованные агрегации нужны для читаемости: двухуровневые заголовки ломают и выгрузку в отчёт, и построение графика по этой таблице. Двухуровневые заголовки ломают и выгрузку, и построение графика.
Число строк в результате равно числу уникальных значений ключа, столбцов столько, сколько признаков умножено на число агрегатов, ни в одном столбце нет пропусков из-за пустых групп. Ключ группировки не содержит пропусков.
Оставить двухуровневые заголовки: обращение к столбцу по имени не работает, график по таблице не строится, и время уходит на переделку. Вторая ошибка — забыть count и получить таблицу без числа наблюдений в группах.
Проверяет, все ли пять агрегатов присутствуют: count чаще всего забывают. Пять агрегатов из задания он ищет поимённо, и отсутствие count сразу заметно.
Шаг 5.2.2
Сверяем группировку с исходными данными: сумма count по группам должна равняться числу строк после фильтрации, сумма sum по группам — общей сумме по столбцу. Одну группу проверяем вручную: отбираем строки фильтром, считаем среднее напрямую и сравниваем с таблицей. Если числа не сошлись, ищем причину: пропуски, дубли, неверный ключ. Причина чаще всего в пропусках в ключе.
Перекрёстная проверка занимает две минуты и ловит ошибки, которые не видны в коде: например, группировку по признаку с пропусками, где часть строк молча выпадает. Ответы на частные вопросы стоят 5 баллов, и они должны быть верными, а не правдоподобными.
Сумма count равна числу строк в отфильтрованном наборе, сумма sum совпадает с прямым расчётом, контрольная группа даёт то же среднее, что и ручной расчёт. Расхождение хотя бы в одном числе означает ошибку в фильтре или в ключе.
Группировать по столбцу с пропусками и не заметить, что часть строк исчезла: число в ответе меньше правильного, и балл не ставится. Правильно заранее проверить ключ на пропуски и заполнить их категорией неизвестно.
Может попросить показать ручную проверку одной группы: это признак надёжной работы. Он просит показать одну группу и сверить её с прямым расчётом по строкам.
Шаг 5.2.3
Сортируем результат по нужному столбцу через sort_values с ascending=False, выводим топ-5 и антитоп-5 и сопровождаем вывод фразой о том, что это значит для задачи работодателя. Если вопрос звучит как «в какой группе показатель выше», ответом должны быть название группы и разница в числах, а не сама таблица. Если вопрос про долю, дополнительно считаем процент от общего числа строк.
Частные вопросы почти всегда про сравнение групп, поэтому ответ в виде названия группы и числа — то, что ожидает увидеть эксперт. Сортировка и топ нужны, чтобы ответ не приходилось выискивать в таблице на двадцать строк. Ответ в виде таблицы без вывода читается как незавершённая работа.
Названы конкретные группы с числами, разница посчитана в абсолютных единицах или в процентах, таблица отсортирована, топ выделен в тексте. Если разница между группами меньше погрешности, об этом пишется прямо.
Сдать таблицу без вывода: эксперт видит данные, но не видит ответа, и вопрос считается неотвеченным. Вторая ошибка — сравнивать группы без учёта их размера: в маленькой группе среднее скачет от одной строки.
Читает именно текст вывода: сравнение групп должно быть сформулировано словами. Он ищет в тексте название группы и число, а не таблицу на двадцать строк.
Действие 5.3. Построить графики для отчёта
Шаг 5.3.1
Для каждой группировки строим столбиковую диаграмму: sns.barplot с ключом по оси x и показателем по оси y, значения над столбцами через plt.bar_label или цикл по контейнерам, сортировка по убыванию, поворот подписей категорий на 45 градусов, если названия длинные. Для долей вместо barplot берём горизонтальные полосы, тогда длинные названия читаются без поворота.
Пять баллов за графики, визуализирующие выполненный анализ, и три балла за качество оформления — это единственные баллы, которые зависят от внешнего вида. Подписи значений над столбцами обязательны: без них читатель не может сравнить группы точнее, чем «выше-ниже».
На каждом графике подписаны обе оси с единицами, есть заголовок с формулировкой вопроса, категории не наезжают друг на друга, значения читаются, легенда есть только там, где она нужна. Цвет столбца не должен нести смысл без легенды.
График без подписи осей и заголовка: балл за качество снимается, а иногда и балл за сам график, потому что непонятно, что изображено. Второй провал — повёрнутые на 90 градусов подписи, которые всё равно наезжают.
Оценивает читаемость: подписи, единицы, отсутствие наложений, единый стиль на всех графиках. Он оценивает и то, что тип графика соответствует данным: доли — полосы, динамика — линия.
Шаг 5.3.2
Приводим все графики к одному виду: один размер фигуры, один размер шрифта не меньше 10, одинаковая палитра, сетка только по оси значений и полупрозрачная. Каждый график сохраняем отдельным файлом через plt.savefig с параметрами dpi=150 и bbox_inches=равно tight, чтобы подписи не обрезались, и сразу после сохранения вызываем plt.show(), а фигуру закрываем через plt.close().
Единый стиль — это и есть качество диаграмм на 3 балла. Сохранение в файл нужно, потому что ноутбук сдают вместе с отчётом, а вставка картинки в текст требует файла. bbox_inches=равно tight спасает от обрезанных подписей, а plt.close избавляет от наложения графиков друг на друга при последовательном построении.
Все файлы графиков лежат в папке отчёта, размер каждого больше пятидесяти килобайт, ни одна подпись не обрезана, шрифт на всех графиках одинаковый. Все графики сохранены в одну папку и названы по смыслу, а не по номеру ячейки.
Не закрывать фигуры: следующий график рисуется поверх предыдущего, и в отчёт попадает каша из двух диаграмм. Правильно закрывать фигуру после сохранения и строить каждый график в отдельной ячейке. Графики строятся по одному на ячейку.
Смотрит на сохранённые файлы, а не только на экран ноутбука: именно они попадут в отчёт. Он открывает два-три файла и сравнивает размер шрифта и палитру.
Действие 5.4. Оформить отчёт об исследовании
Шаг 5.4.1
Структурируем отчёт по разделам: постановка задачи, описание данных, предобработка, распределения, описательные статистики, корреляции, ответы на частные вопросы, выводы. Разделы делаем заголовками markdown разного уровня, графики вставляем сразу после соответствующего вывода и подписываем снизу как «Рисунок 1 — распределение признака», нумеруя по порядку.
Четыре балла за оформленный отчёт и три за качество оформления — семь баллов, которые теряются чаще всего просто потому, что отчёт собран как набор ячеек без структуры. Нумерация рисунков нужна для ссылок в тексте: «на рисунке 3 видно» работает только при наличии номеров.
Каждый раздел на месте, у каждого рисунка есть номер и подпись, в тексте есть ссылки на рисунки, отчёт читается сверху вниз без обращения к коду. В отчёте есть ответы на все частные вопросы, а не только общие разделы.
Сдать ноутбук без текстовых разделов: эксперт видит код и графики, но не видит исследования, и оценочные баллы снимаются. Вторая ошибка — вставить все графики в конец: связь графика с выводом теряется.
Читает отчёт как документ и ищет выводы по каждому пункту задания. Он читает раздел выводов первым, потому что именно там видно, решена ли задача. Разделы он ищет по заголовкам.
Шаг 5.4.2
Дописываем итоговые выводы: три-пять предложений о том, какие признаки связаны с целевой переменной, какие группы различаются сильнее всего, какие ограничения есть у исследования. Отдельно фиксируем, какие признаки пойдут в модель и почему — это прямой мост к модулю С. Затем выполняем Restart and Run All и проверяем, что все графики и числа в тексте совпадают с выводом ячеек.
Выводы связывают модуль В с модулем С: отбор признаков в модели должен опираться на корреляции, которые вы только что посчитали. Финальный перезапуск нужен потому, что после правок в середине ноутбука часть ячеек могла считаться на старых данных. Перезапуск занимает минуту и снимает сомнения.
Числа в тексте отчёта совпадают с выводом после полного перезапуска, ни одна ячейка не падает, список признаков для модели записан явно и совпадает с тем, что будет использовано в модуле С. Список признаков для модели записан явно.
Писать выводы до перезапуска и получить расхождение чисел: эксперт сверяет текст с выводом ячеек, и расхождение читается как выдуманные результаты. Второй риск — оставить в тексте числа от старой версии данных.
Сверяет хотя бы два числа из текста с выводом ячеек — это самая быстрая проверка достоверности отчёта. Он сверяет два-три числа из текста с выводом ячеек выборочно.
Задача 6. Обучить модель, оценить качество и сохранить еёМодуль С · 25 баллов · 1 ч 20 мин
Модуль С — самый короткий по объёму работы и самый плотный по баллам: 25 баллов за пять действий, по пять за каждое. Разделить данные на обучающую и проверочную части, обучить заданную модель, посчитать метрики, сделать вывод о пригодности и сохранить модель в требуемом формате. Задание здесь меняется чаще всего: задача может оказаться регрессией или классификацией, поэтому первым делом читается формулировка, а уже потом выбирается алгоритм и метрики.
Действие 6.1. Разделить данные на обучение и проверку
Шаг 6.1.1
Отделяем целевую переменную: y равно df[target], X равно df.drop(columns=[target]). Из X убираем идентификаторы, даты и служебные столбцы, а также признаки, которых в момент предсказания ещё не существует. Выводим список столбцов X и проверяем, что целевой переменной в нём нет, а все столбцы числовые. Отдельно проверяем, что в X нет столбцов, посчитанных из целевой переменной.
Пять баллов за разделение данных ставятся по факту выполнения, но ошибка в X обнуляет смысл всей модели: если в признаках остался идентификатор, модель выучит его и покажет прекрасные метрики на обучении и случайные на новых данных. Утечка цели в признаки — вторая по частоте причина провала модуля С.
df.select_dtypes по X не содержит object, target отсутствует в X, число столбцов уменьшилось ровно на число удалённых, длины X и y совпадают. Список столбцов X выводится целиком, чтобы видеть, что осталось после удаления.
Оставить в X столбец, из которого целевая переменная вычисляется, — например сумму, по которой определяется класс: метрика выходит 0,99, и эксперт сразу видит причину. Вторая ошибка — оставить столбец с пропусками в целевой переменной.
Просит назвать признаки, использованные в модели, и отдельно спрашивает, нет ли среди них Target Leakage. Он просит назвать признаки, которых в момент предсказания ещё не существует.
Шаг 6.1.2
Делим выборку через train_test_split с test_size=0.2, random_state=42 и stratify=y для классификации, чтобы доли классов сохранились в обеих частях. Для маленьких наборов берём test_size=0.25 или 0.3. Печатаем формы четырёх массивов X_train, X_test, y_train, y_test и доли классов в каждом. Для маленьких наборов test_size увеличиваем до 0,3, иначе проверка получается нестабильной.
Пять баллов за разделение данных требуют явного разделения на два набора с фиксированным зерном. stratify нужен потому, что при редком классе в 5 процентов случайное деление может оставить в проверке три объекта, и recall по нему будет скакать от нуля до единицы.
Сумма длин train и test равна длине исходного набора, доли классов в частях отличаются не больше чем на пару процентных пунктов, random_state указан числом. Отдельно проверяем, что индексы строк не остались общими у train и test.
Разделить без stratify при несбалансированных классах: метрики по редкому классу получаются случайными, и вывод о качестве модели оказывается неверным. Вторая ошибка — делить данные после обучения модели, тогда проверка бессмысленна.
Проверяет, указан ли test_size и random_state, и что разделение выполнено до обучения, а не после. Он сверяет размеры массивов с исходной таблицей, чтобы поймать потерянные строки.
Шаг 6.1.3
Если масштабирование и кодирование ещё не выполнялись на этом этапе, обучаем преобразователи только на X_train через fit_transform, а к X_test применяем transform. Когда предобработка уже сделана в модуле А на всей таблице, честно фиксируем это в отчёте одной фразой и объясняем, чем это может завысить метрику. Если в таблице остались категориальные столбцы, кодирование выполняется до разделения.
Порядок «сначала разделили, потом обучили преобразователи на train» — обязательное условие корректной оценки. Если scaler обучался на всём наборе, проверка перестаёт быть независимой, и метрика оказывается оптимистичной, а на защите это первый вопрос, который задаёт эксперт.
В коде видно, что fit вызывается на train, а transform на test; среднее и стандартное отклонение по test после масштабирования близки к нулю и единице, но не равны точно. Порядок вызовов виден в коде и в отчёте описан одной фразой.
Вызвать fit_transform на всём X и потом делить: метрика завышается, и разница между train и test исчезает, хотя её не должно быть. Правильно делить сразу после загрузки и заполнения пропусков, а масштабировать уже внутри.
Смотрит именно на порядок вызовов fit и transform: это техническая деталь, которая отличает сильного участника. Он смотрит и на то, что заполнение пропусков тоже не подглядывало в тест.
Действие 6.2. Выбрать и обучить модель
Шаг 6.2.1
Выбираем алгоритм по типу задачи и записываем обоснование одним абзацем. Для регрессии — LinearRegression как базовая линия, при явной нелинейности RandomForestRegressor; для классификации — LogisticRegression при линейной границе и RandomForestClassifier, если признаки разнородные. В обосновании указываем число строк и признаки, потому что от этого зависит выбор.
Формулировка задачи в модуле С меняется на площадке в тридцати процентах случаев, поэтому модель выбирается по данным, а не по привычке. Пять баллов за обученную модель и оценочная часть за обоснование требуют, чтобы выбор звучал как аргумент, а не как название библиотеки.
Название модели совпадает с типом задачи, обоснование содержит минимум одну ссылку на свойство данных, модель импортирована из sklearn и создана с явными параметрами. В обосновании есть число строк и хотя бы одна характеристика признаков.
Взять случайный лес на сотне строк: модель переобучается идеально, метрика на проверке проваливается, и объяснить это без обоснования выбора нельзя. Правильнее начать с простой модели, получить базовую метрику и уже потом усложнять.
Спрашивает, почему выбрана эта модель и что было бы при другой: ответ должен опираться на размер данных и природу признаков. Ответ про другую модель должен звучать так же уверенно.
Шаг 6.2.2
Обучаем модель через model.fit(X_train, y_train) и сразу проверяем, что объект обучен: выводим число признаков из model.n_features_in_ и, если есть, свободный член и число итераций. Для регрессии смотрите на model.coef_ и model.intercept_, для дерева — на глубину через get_depth. Никаких действий с тестом на этом шаге. Если обучение идёт больше минуты, проверяем число итераций и размер данных.
Пять баллов за обученную модель — это буквально вызов fit на подготовленных данных, но проверка после него нужна, чтобы отличить обучение от создания объекта: половина ошибок в этом модуле связана с тем, что модель создана, но не обучена, и predict выдаёт ошибку уже на проверке.
model.n_features_in_ равно числу столбцов X_train, коэффициенты или глубина выведены и правдоподобны, predict на пяти строках train возвращает значения того же типа, что и y. Для дерева дополнительно выводится число листьев.
Забыть fit и вызвать predict: sklearn выдаёт ошибку NotFittedError, время уходит, а нервы — тоже, хотя достаточно было одной строки проверки. Вторая ошибка — обучить модель на тесте и потом честно мерить на нём же.
Проверяет, что объект модели обучен, а не только объявлен: смотрит на наличие атрибутов после fit. Он же смотрит на параметры модели: глубина дерева и число деревьев должны быть заданы явно.
Шаг 6.2.3
Получаем предсказания на обеих частях: y_pred_train и y_pred_test. Сравниваем первые пять значений с фактическими, выводим диапазон предсказаний через min и max. Для регрессии проверяем, что предсказания не выходят за физически возможные границы, для классификации — что среди предсказанных классов встречаются все классы из обучения. Предсказания округляем только для вывода, не для метрик.
Сравнение предсказаний с фактом на пяти строках — самый быстрый способ заметить сдвиг: модель, предсказывающая всем одно и то же среднее, формально обучена, но бесполезна, и это видно именно здесь, до расчёта метрик. Модель, предсказывающая одно и то же среднее, формально обучена, но бесполезна.
Диапазон предсказаний пересекается с диапазоном фактических значений, ни одно предсказание не отрицательно там, где отрицательных значений не бывает, набор классов совпадает. Для классификации дополнительно выводим распределение предсказанных классов.
Не посмотреть на предсказания и обнаружить проблему только по метрике: причина ошибки остаётся непонятной, и время уходит на перебор гипотез. Вторая ошибка — не посмотреть на масштаб: предсказания в тысячах при цели в рублях.
Может попросить показать три предсказания рядом с фактом: это проверка понимания, а не подгонки. Он спрашивает, почему предсказания не выходят за границы возможного.
Действие 6.3. Посчитать метрики и сделать вывод
Шаг 6.3.1
Для регрессии считаем MAE, RMSE и коэффициент детерминации R2 через mean_absolute_error, mean_squared_error с squared=False и r2_score; для классификации — accuracy, precision, recall, f1 и матрицу ошибок через confusion_matrix и classification_report. Считаем на train и на test отдельно и выводим таблицей в две строки, чтобы разница была видна сразу.
Пять баллов за вычисленные метрики: должны быть названы именно те, что записаны в задании, плюс базовые. Метрики на train и test рядом нужны для вывода о переобучении: одно число на тесте ничего не говорит о том, выучила модель закономерность или запомнила строки.
Таблица содержит по строке на train и test и по столбцу на каждую метрику, значения в правдоподобных пределах: R2 не больше единицы, MAE в тех же единицах, что и целевая переменная. Число строк в матрице ошибок равно числу классов.
Считать accuracy на несбалансированных классах и радоваться 0,95: при доле редкого класса в 5 процентов модель, всегда предсказывающая самый частый класс, даёт те же 0,95, и вывод о качестве оказывается ложным.
Смотрит, различает ли участник метрики по смыслу и умеет ли объяснить, что показывает каждая. Он проверяет, названы ли метрики именно те, что требует задание, и понимает ли участник их смысл.
Шаг 6.3.2
Сравниваем train и test: если R2 на обучении 0,98, а на проверке 0,45 — это переобучение, и в выводе надо честно назвать причину и возможное лечение. Если метрики близки и обе низкие — модель недообучена, надо усложнять или добавлять признаки. Записываем наблюдение в текст отчёта с числами и одним предложением о причине. При близких метриках причина в недообучении, и это тоже пишется словами.
Пять баллов за вывод о качестве обученной модели ставятся за сравнение, а не за переписывание метрики. Именно здесь эксперт видит, понимает ли участник разницу между запоминанием и обобщением, и это же предложение потом звучит в защите. Сравнение метрик — основа вывода о целесообразности.
В тексте есть оба числа и разница между ними, названа одна причина и одно направление улучшения, вывод не сводится к фразе «модель показала хорошие результаты». В выводе назван хотя бы один способ уменьшить разрыв.
Написать вывод по одной метрике на тесте без сравнения: оценочные баллы снимаются, потому что обещанного вывода о целесообразности нет. Вторая ошибка — объяснять переобучение нехваткой данных, не проверив размер выборки.
Задаёт вопрос о разнице между train и test: ответ должен быть готов и с числами. Он задаёт вопрос о разнице метрик и ждёт числа, а не общих слов про переобучение.
Шаг 6.3.3
Формулируем вывод о целесообразности применения: пригодна ли модель, для каких решений, с какими оговорками. Формулировка прикладная: например, средняя ошибка составляет столько-то рублей, что для задачи такой-то приемлемо, а для задачи такой-то нет. Отдельно называем два ограничения своего решения и два способа улучшения. Формулировка должна быть понятна человеку без знания машинного обучения.
Пятый пункт критериев прямо требует вывода о целесообразности использования модели в прикладных решениях, и он оценивается отдельно от метрик. Прикладная формулировка важна потому, что перевод ошибки в деньги, дни или проценты — это и есть работа специалиста по данным.
В выводе есть ответ «да» или «нет» с обоснованием, ошибка переведена в единицы задачи, названы минимум два ограничения и два улучшения. Указано, при какой ошибке модель применять нельзя, — это и есть граница применимости.
Написать «модель можно использовать» без чисел: балл за вывод не ставится, даже если метрики посчитаны верно. Вторая ошибка — обещать точность выше полученной: расхождение с метриками снимает балл. Вывод должен быть скромнее метрик.
Читает вывод и проверяет, согласуется ли он с метриками: завышенные обещания при слабых метриках снимают балл. Он сверяет вывод с метриками и с заданием, для которого модель строилась.
Действие 6.4. Сохранить модель в требуемом формате
Шаг 6.4.1
Сохраняем обученную модель через pickle или joblib в файл с понятным именем, например model.pkl, рядом кладём список признаков в том же порядке, сохранённые медианы для заполнения пропусков и scaler, если он применялся. Удобный вариант — собрать всё в Pipeline ещё до обучения: тогда один файл содержит и преобразования, и модель, и порядок применения не собьётся.
Пять баллов за сохранённую модель дают только за файл, который можно загрузить и применить к новым данным. Модель без списка признаков бесполезна: порядок столбцов на входе должен совпадать с обучением, иначе предсказания будут молча неверными. Порядок столбцов при загрузке должен совпадать с обучением.
Файл создан, его размер больше нескольких килобайт, рядом лежит список признаков, в pickle нет ссылок на объекты, которых нет в окружении, — проверяется загрузкой. Список признаков сохранён рядом с моделью и совпадает с X.columns.
Сохранить scaler отдельно и забыть про него при загрузке: предсказания на новых данных считаются по немасштабированным числам и оказываются бессмысленными. Вторая ошибка — сохранять модель, обученную на других признаках, чем лежат в X.
Проверяет именно загрузку и применение, а не наличие файла: файл без возможности загрузить баллов не даёт. Он проверяет, что рядом с моделью есть всё нужное для её применения.
Шаг 6.4.2
Проверяем сохранение: в новой ячейке с чистым ядром загружаем модель, берём три строки из X_test, считаем предсказания и сравниваем с теми, что были до сохранения — они должны совпасть до последнего знака. Дополнительно сохраняем в файл сами метрики и выводим их при загрузке, чтобы отчёт и модель не расходились. Если предсказания не совпали, ищем потерянное преобразование, а не переучиваем модель.
Проверка в чистом ядре моделирует то, что будет делать проверяющий: если предсказания совпали, модель полная; если нет — не хватает преобразования или сбит порядок столбцов. Это последняя возможность поймать ошибку до сдачи. Именно так работа проверяется на чужой машине, где нет ваших переменных.
Предсказания после загрузки совпадают с исходными с точностью до знака, модель загружается за секунды, метрики из файла совпадают с посчитанными. Файл модели открывается без дополнительных настроек окружения.
Проверять загрузку в том же ядре, где остались переменные: расхождение не проявится, а на чужой машине модель не заработает. Правильно проверять загрузку в отдельном ноутбуке, где нет ни одной переменной из основного.
Может сам открыть ваш файл и применить модель к одной строке — это финальная проверка модуля С. На эту сверку у него уходит меньше минуты. Без загрузки балл за сохранение не ставится.
Задача 7. Сдать работу и представить результат экспертамСдача · 0 баллов, но от неё зависит вся оценка
Последние двадцать минут не дают баллов, но могут их отнять: работа, которую невозможно открыть, оценивается в ноль, и никакие метрики этого не исправят. Кроме того, в задании отдельным пунктом стоит представление результатов работы перед экспертами, и от короткого рассказа зависит, поймут ли, что сделано. Здесь же проверяется, что все три модуля сошлись: датафрейм, отчёт и модель лежат на месте и согласованы друг с другом.
Действие 7.1. Привести в порядок файлы
Шаг 7.1.1
Проверяем состав папки по чек-листу из критериев: ноутбук с кодом, data_clean.csv, графики в png, model.pkl со списком признаков, файл с метриками. Имена файлов делаем понятными и без пробелов, латиницей. Копируем папку целиком в место сдачи, указанное экспертом, и проверяем, что копия открывается. Проверяем и то, что ноутбук не тянет данные с рабочего стола или из загрузок.
Эксперт оценивает пять пунктов модуля С и десять пунктов модуля А по файлам, а не по вашему экрану. Работа с именами вида «новый файл 2» читается как незавершённость, и часть баллов уходит на пустом месте. Проверка копии нужна потому, что путь сдачи иногда другой, а права на запись — не всегда.
В папке ровно те файлы, что в чек-листе, копия открывается с другого пути, ноутбук запускается и не ищет данные по абсолютному пути вида C:/Users/имя. Все пути в коде относительные, ни одного абсолютного адреса не осталось.
Оставить в ноутбуке абсолютные пути к своим файлам: на машине эксперта загрузка падает, и работа выглядит нерабочей. Вторая ошибка — сдать папку с данными, но без ноутбука: проверить нечего, кроме файлов.
Открывает папку сдачи и запускает ноутбук: первое, что проверяется, — открывается ли вообще. Он открывает ноутбук и запускает его: работоспособность проверяется первой.
Шаг 7.1.2
Финальный прогон: Restart and Run All на чистом ядре, затем просмотр всех выводов на предупреждения. Убираем лишние эксперименты и ячейки с ошибками, оставляем рабочий ход. В конце добавляем короткую ячейку с итогом: число строк, число признаков, выбранная модель, метрика на тесте, путь к файлу модели. Если какая-то ячейка зависит от старой переменной, она переносится в начало или удаляется.
Полный перезапуск — единственный способ убедиться, что работа воспроизводится с нуля. Итоговая ячейка экономит эксперту время и показывает, что участник понимает результат целиком, а не по частям. Если работа не воспроизводится с нуля, эксперт не может проверить ни один пункт критериев.
Все ячейки выполняются по порядку без ошибок, предупреждений о будущих изменениях библиотек нет или они объяснены, итоговая ячейка выводит шесть нужных чисел и путей. Итоговая ячейка выводит число строк, число признаков, модель, метрику и путь к файлу.
Оставить в ноутбуке ячейку с ошибкой и объяснить это словами «это не влияет»: эксперт видит красный вывод и снижает оценку за качество работы. Вторая ошибка — оставлять в ноутбуке черновые ячейки с экспериментами.
Именно перезапуском и проверяет: часто именно на этом шаге обнаруживается, что половина кода зависела от старых переменных. Он смотрит и на то, что все графики строятся при перезапуске заново.
Действие 7.2. Представить работу экспертам
Шаг 7.2.1
Готовим рассказ на две-три минуты по жёсткой структуре: что за данные и сколько в них строк и признаков, что пришлось исправить при предобработке, что показал анализ и какие признаки связаны с целью, какая модель обучена и какие метрики получились, какие ограничения есть. Держим перед глазами итоговую ячейку ноутбука: все числа оттуда. Рассказ репетируем один раз вслух, с таймером.
Представление результатов — отдельный пункт задания, и он влияет на оценочные баллы за вывод о качестве модели и за отчёт. Рассказ по структуре показывает, что участник владеет результатом, а не пересказывает код. Слушатель должен понять ход работы без обращения к коду.
Рассказ укладывается в три минуты, в нём звучат минимум пять чисел из работы, ни одно число не расходится с ноутбуком, структура проходит все пять пунктов. Все числа в рассказе взяты из итоговой ячейки, а не из памяти.
Начать рассказ с перечисления библиотек и алгоритмов, не сказав, что за данные и какой результат: эксперт не понимает контекста и не успевает дойти до метрик. Вторая ошибка — рассказывать про библиотеки вместо результата.
Слушает и задаёт два вопроса: про обоснование метода заполнения пропусков и про разницу метрик на обучении и проверке. Он оценивает и структуру ответа, и умение выделить главное.
Шаг 7.2.2
Готовим ответы на три вероятных вопроса заранее, по одному предложению на каждый: почему выбран именно этот метод обработки пропусков, почему выбрана эта модель, что будет, если данных станет в сто раз больше. Отвечаем коротко и с числом, а если ответа нет — говорим прямо, что это ограничение работы и как его проверять. Ответы лучше записать на бумаге, чтобы не искать формулировку в момент вопроса.
Оценочная часть баллов ставится в том числе за понимание: участник, который может объяснить свои решения, получает больше, чем тот, у кого код работает случайно. Честное «не проверял, но проверяется так-то» ценится выше, чем выдуманный ответ. Честность здесь ценится выше уверенного тона.
На каждый из трёх вопросов есть ответ в одно-два предложения с числом или с названием проверки, ответы не противоречат отчёту. Если ответа нет, участник называет способ, которым это можно проверить, — такой ответ тоже засчитывается.
Отвечать общими словами про важность машинного обучения: эксперт делает вывод, что участник не понимает собственного решения. Вторая ошибка — спорить с экспертом вместо объяснения своего решения. Уверенный тон не заменяет понимания.
Смотрит на уверенность и на связь ответа с тем, что реально сделано в ноутбуке. Он сверяет ответ с тем, что реально сделано, и с числами из итоговой ячейки.
Студент
учащиеся колледжей и техникумовВ официальном файле категории не разделены отдельными разделами — приводим задание целиком; различия по категориям смотрите в таблице модулей.
Пошаговое решение
Студенческая категория — это четыре с половиной часа на три связанных модуля по сто тридцать минут и сто баллов: сбор и предобработка данных (35), анализ и визуализация (40), обучение и оценка модели (25). Задание построено как конвейер: из нескольких структурированных источников нужно собрать один набор, вычистить пропуски и типы, отмасштабировать количественные признаки, закодировать категориальные, упаковать всё это в конвейер обработки, показать распределения, статистики и корреляцию с выводами, ответить на частные вопросы работодателя через фильтрацию и группировки и, наконец, обучить заданную модель с честной оценкой на отложенной выборке. Главные риски распределены по модулям: в А — незаметное размножение строк при соединении источников, в В — графики без выводов и статистики без моды, в С — утечка через предобработку, после которой метрики выглядят лучше, чем есть.
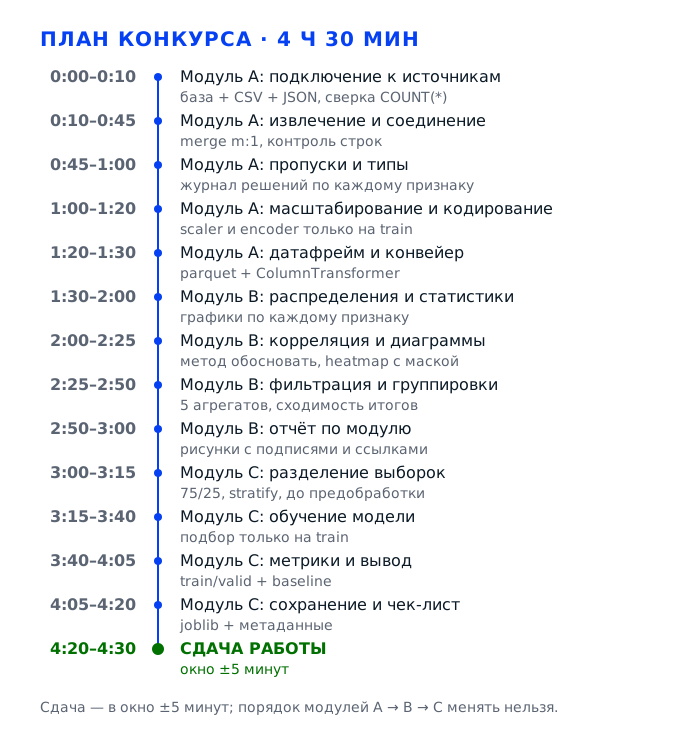
Задача 1. Модуль А: подключиться к источникам и собрать единый набор данныхМодуль А · 8 из 35 баллов
Первый час тридцати минут уходит на то, чтобы из нескольких заданных источников получился один датафрейм, которому можно верить: подключение, извлечение, соединение по ключу и описание структуры. Именно здесь набираются первые восемь баллов модуля А — два за подключение, три за извлечение из всех источников и три за описанную структуру, — и здесь же закладывается главная ловушка всего задания: незаметное размножение строк при соединении, после которого все средние и корреляции в модуле В считаются неизвестно по чему.
Действие 1.1. Развернуть окружение и открыть каждый источник
Шаг 1.1.1
Открываем терминал, создаём папку решения module_a и в ней три подпапки: data, figs, report. Первой ячейкой ноутбука печатаем версии pandas, numpy, scikit-learn, matplotlib и seaborn и тут же переписываем их в requirements.txt. Следующей строкой фиксируем RANDOM_STATE = 42 и дальше во всех вызовах используем только эту константу. Данные из задания копируем в data/readonly и работаем с копией, а не с исходником.
Критерий «выполнено подключение к источнику данных» стоит 2 балла, но проверяется он не наличием импорта, а тем, что ноутбук проходит сверху вниз на чистом ядре. Фиксированный random_state нужен для воспроизводимости: числа из отчёта эксперт сверяет с повторным прогоном, и они должны совпасть до последнего знака.
Kernel → Restart и Run All доходит до последней ячейки без ошибок, в выводе первой ячейки виден рабочий путь и версии библиотек, они же лежат в requirements.txt. В data/readonly остался исходный файл в том виде, в котором его выдали.
Работать прямо в файле из задания: после первого to_csv исходник затёрт, и повторно извлечь данные нечем — модуль А приходится сдавать по памяти. Вторая ошибка — абсолютные пути вида C:/Users/student/..., которые на площадке указывают в другой домашний каталог, и ноутбук падает на первой же строке.
Эксперт запускает ваш ноутбук на чистом ядре и смотрит, доходит ли он до конца без ручных правок: это и есть настоящая проверка подключения и воспроизводимости.
Шаг 1.1.2
Подключаемся к базе из задания: собираем строку create_engine с драйвером psycopg2 или sqlite3 и сначала забираем схему — SELECT column_name, data_type FROM information_schema.columns WHERE table_name = '...'. Только после этого читаем данные через pd.read_sql с явным списком столбцов. Объём проверяем отдельным запросом SELECT COUNT(*) и сверяем с len(df).
Подключение приносит 2 балла и должно быть видно в коде, а не подразумеваться. Явный список столбцов экономит память: SELECT * по таблице на несколько сотен тысяч строк съедает таймаут и роняет ядро в середине работы, а восстановление ноутбука стоит дороже, чем аккуратное чтение.
COUNT(*) из базы равен len(df) — выведите оба числа рядом и убедитесь, что они совпадают. Первые пять строк читаемы, типы столбцов совпадают с information_schema, среди названий нет служебных вида unnamed: 0.
Тянуть таблицу целиком без фильтра и без списка столбцов: чтение занимает минуты, и половина модуля А уходит в ожидание. Вторая ошибка — не закрыть соединение: на площадке пул на три подключения, и второе чтение падает с сообщением too many clients.
Смотрит на строку подключения и на сверку количества строк с базой: подключение, про которое нельзя сказать, сколько строк пришло, считают формальным.
Шаг 1.1.3
Читаем CSV через pd.read_csv с явными параметрами sep и encoding — разделитель и кодировку проверяем по первой строке файла, а не угадываем. JSON разворачиваем через pd.json_normalize с record_path и meta, чтобы вложенные объекты стали плоскими столбцами. Ключи и идентификаторы читаем строкой через dtype, иначе '007' превратится в 7 и соединение с базой даст ноль совпадений.
Извлечение из нескольких источников — это 3 балла, и набор должен быть собран из всех заданных источников, а не из одного удобного. Кодировка cp1251 вместо utf-8 даёт ромбики в категориальных признаках, после чего сопоставить эти категории с таблицей из базы уже невозможно.
df.shape совпадает с числом строк в файле, df.head() показывает читаемые русские подписи без символов Ð, dtype ключевого столбца — object, а не int64. В таблице из JSON каждый вложенный элемент стал отдельной строкой, а не списком в ячейке.
Читать CSV с кодировкой по умолчанию: файл выгружен из 1С в cp1251, и вместо категорий получаются битые символы, по которым объединение даёт пустоту. Вторая ошибка — оставить ключ числом: совпадений с текстовым ключом базы не будет ни одного.
Проверяет, что источников в коде столько же, сколько в задании, что каждый прочитан с явными параметрами, а не «как получилось», и что форма каждого датафрейма выведена на экран отдельной строкой. Без этих трёх чисел разговор про извлечение данных не начинается.
Действие 1.2. Соединить источники и удержать целостность строк
Шаг 1.2.1
Выписываем ключ соединения в каждом источнике и сравниваем множества: set из базы и set из файла, затем размеры пересечения и разностей в обе стороны. Отдельно смотрим формат — регистр, пробелы по краям, дефисы в номерах — и приводим к одному виду через strip и upper. Считаем число уникальных ключей в каждом источнике, проверяем уникальность, а строки с пустым ключом отбрасываем и отдельно фиксируем, сколько их было.
Связность набора — часть 3 баллов за извлечение данных. Если ключи не сходятся, получается таблица с половиной пустых строк, и дальше вы лечите заполнением пропусков то, что на самом деле является ошибкой соединения. Время модуля А при этом уходит на борьбу с последствиями, а не с причиной.
Пересечение содержит не меньше 90% ключей меньшего источника, после нормализации число несовпавших падает почти до нуля. По каждому источнику распечатана пара «всего строк / уникальных ключей»: для справочника эти числа равны.
Соединять по ключу как есть, с разным регистром и пробелами: часть строк уходит в NaN, и вы полчаса выясняете, почему у трети клиентов нет региона. Вторая ошибка — не проверить уникальность ключа в справочнике: три дубля в нём дают три копии каждой строки факта.
Смотрит, есть ли в коде шаг нормализации ключа и цифры пересечения множеств: это признак того, что данные действительно свели, а не соединили наудачу, и что потери строк посчитаны до, а не после.
Шаг 1.2.2
Соединяем через merge с параметрами on, how='left', validate='m:1' и indicator=True. Параметр validate сразу падает с ошибкой, если ключ в справочнике не уникален, — это дешевле, чем искать размножение строк потом. После соединения печатаем value_counts по столбцу _merge и разбираем каждую группу left_only построчно: это либо новые клиенты, либо битые ключи.
Соединение и его контроль — сердце трёх баллов за извлечение. Режим left сохраняет все строки факта, а indicator показывает, сколько из них не нашло пару: без этого пропуски в справочных признаках выглядят как дефект данных, и вы начинаете их заполнять вместо того, чтобы разобраться.
len(merged) равно len(fact) при валидации m:1, доли both и left_only объяснены в отчёте словами. В результате нет столбцов с суффиксами _x и _y, а число строк до и после соединения выведено двумя числами рядом — по ним размножение видно сразу.
Использовать how='inner' по умолчанию: строка без пары в справочнике молча исчезает, и вы теряете часть выборки, о которой даже не узнаете. Вторая ошибка — merge без validate: справочник с дублями тихо умножает строки, и все средние в отчёте уезжают.
Спрашивает, сколько строк не нашло пару и почему: если участник не может назвать это число, значит соединение не контролировалось, и дальше доверия к его таблице уже нет.
Шаг 1.2.3
Считаем контрольные точки до и после каждого соединения: число строк, число уникальных ключей, сумму числового признака и число пропусков по пяти ключевым столбцам. Складываем их в маленькую таблицу с колонками шаг, строк, ключей, сумма и выводим на экран одной таблицей. Первую версию набора сохраняем отдельным файлом и дальше не перезаписываем. Таблица занимает две минуты, а экономит весь модуль А.
Эта таблица контрольных точек защищает от главной ошибки конвейера — незаметного размножения строк, которое обнаруживается только на графиках в модуле В. Она же идёт в отчёт как доказательство корректной сборки и подпирает 3 балла за структуру набора, потому что показывает путь данных по шагам, а не только конечный результат.
Сумма числового признака после соединения m:1 не изменилась, число строк выросло ровно на число добавленных столбцов, а не на число записей. Если сумма изменилась — соединение было 1:N, ищите дубли в справочнике.
Не сохранять промежуточный срез: после трёх преобразований уже не понять, на каком шаге строк стало вдвое больше, и переделывать приходится весь модуль А. Вторая ошибка — сверять только количество строк: размножение с одновременной потерей части строк даёт то же число.
Просит показать таблицу контрольных точек: по ней сразу видно, контролировал ли участник целостность данных на каждом шаге, или просто склеил файлы и надеется, что всё сошлось.
Действие 1.3. Описать структуру набора и зафиксировать роли признаков
Шаг 1.3.1
Печатаем df.info, nunique по убыванию, пять случайных строк с фиксированным random_state и долю пропусков по каждому столбцу в процентах. По каждому признаку выписываем четыре вещи: тип, число уникальных значений, долю пропусков и диапазон значений. Это и есть описание структуры набора, которого требует задание в первом пункте модуля А. Всё это занимает одну ячейку и повторяется без правок при любом перезапуске.
Критерий «описана структура набора данных» — 3 балла, и проверяется он по тексту отчёта: должны быть перечислены признаки с типами и смыслом, а не приложен скриншот info. Без этого описания эксперту непонятно, с чем вы работали, и остальные выводы висят в воздухе.
Число столбцов в info совпадает с числом строк в вашей таблице описания. Ни один признак не остался с типом object при том, что в нём числа, — такие выписаны отдельным списком на следующий шаг, чтобы не потерялись среди остальных.
Ограничиться выводом info в ноутбуке и не перенести описание в отчёт: эксперту нечего оценивать, и 3 балла превращаются в ноль. Вторая ошибка — описывать признаки по названиям столбцов, не заглянув в значения: смысл столбца sum_1 по имени не угадывается.
Сверяет таблицу описания с фактическим составом датафрейма: пропущенный столбец или признак, которого в данных нет, виден сразу и стоит трёх баллов за структуру.
Шаг 1.3.2
Размечаем признаки по ролям прямо в таблице: количественные, категориальные номинальные и порядковые, дата и время, идентификаторы, целевая переменная. Для каждого пишем единицу измерения — рубли, штуки, дни, — потому что от неё зависят подписи на графиках и трактовка метрик. Идентификаторы и дату помечаем как «не признаки», в модель их не берём, и это решение тоже фиксируем.
Дальше вся обработка идёт по этим группам: масштабирование только для количественных, кодирование только для категориальных, отбор только среди признаков. Ошибка в разметке стоит баллов сразу в трёх критериях модуля А, потому что лечится не там, где болит, и замечается только по странным метрикам в модуле С.
Каждый столбец попал ровно в одну группу, сумма по группам равна числу столбцов. Целевая переменная одна и названа явно: если в задании сказано спрогнозировать конкретный показатель, именно этот столбец помечен как целевой.
Скормить идентификатор в модель: он даёт идеальное совпадение на обучении и нулевую пользу на валидации, а метрики выглядят подозрительно хорошо. Вторая ошибка — считать порядковую категорию номинальной и потерять порядок «низкий — средний — высокий».
Смотрит на список признаков, поданных в модель: идентификатор или дата в этом списке — типичный маркер утечки, и объяснение «так получилось» оценку не спасает.
Шаг 1.3.3
Собираем паспорт набора в markdown-таблице: имя признака, тип, единица, диапазон или перечень категорий, доля пропусков, роль в модели и источник — база, CSV или JSON. Ниже абзацем пишем, что представляет собой одна строка набора и сколько их всего. Таблицу вставляем в отчёт в раздел «Описание данных» и дальше ссылаемся на неё по ходу текста. Паспорт пишется один раз и потом только дополняется по ходу работы.
Это готовый ответ на критерий в 3 балла и одновременно оглавление для остальных модулей: по паспорту видно, что масштабировать, а что кодировать, и какие признаки вообще стоит тащить в модель. Эксперт читает отчёт сверху вниз и по паспорту понимает, с какими данными велась работа и откуда взялся каждый столбец.
В таблице столько же строк, сколько столбцов в датафрейме, и ни одна доля пропусков не расходится с выводом isna().mean. В отчёте сказано, что такое одна запись: один заказ, один клиент за месяц, — иначе непонятен уровень агрегации.
Писать паспорт после модели, по памяти: половина признаков окажется с неверными типами, и таблица начнёт противоречить коду. Вторая ошибка — не указать источник: при сведении трёх источников эксперт не сможет проверить, откуда взялся признак.
Открывает раздел «Описание данных» первым: если паспорт сходится с кодом и с заданием, дальше отчёт читается с доверием, а если расходится — остальные выводы проверяются с пристрастием.
Задача 2. Модуль А: очистка, типы, масштабирование, кодирование и конвейерМодуль А · 27 из 35 баллов
Вторая половина модуля А — это двадцать семь баллов на пяти операциях, которые идут строго по порядку задания: пропущенные значения, типы данных, шкалы и масштабирование, категориальные признаки, сохранение датафрейма и сборка конвейера. Порядок нельзя менять местами: пока не исправлены типы, масштабирование падает на строках, а кодирование категорий до заполнения пропусков создаёт отдельный уровень «пусто», которого в данных не было. Плюс здесь же закладывается защита от утечки — все статистики считаются только на обучающей выборке.
Действие 2.1. Разобраться с пропущенными значениями
Шаг 2.1.1
Считаем пропуски по столбцам в абсолютных числах и в процентах, сортируем по убыванию. Строим матрицу пропусков и смотрим, где они идут полосами: полоса означает системный дефект выгрузки, россыпь — обычные пропуски. Отдельно проверяем, не связан ли сам факт пропуска с целевой переменной: сравниваем распределение целевой в строках с пропуском и без него.
Критерий «сделан вывод о наличии пропущенных значений» — 3 балла, и он оценочный: нужен вывод словами, с числом и с объяснением причины. Полосы в матрице часто означают, что часть данных не выгрузилась из источника, и заполнять их средним нельзя — это исказит распределение.
Сумма пропусков по столбцам сходится с общим числом пустых ячеек, в отчёте названы три столбца с наибольшей долей и причина по каждому. Матрица пропусков сохранена в figs с подписью, где сказано, что означают полосы и почему они важнее россыпи.
Сразу вызвать fillna с нулём «чтобы не мешало»: в числовом признаке нули сдвигают среднее и убивают корреляцию, а в категориальном создают уровень, которого в данных не было, и модель обучается на фикции.
Ищет в отчёте причину пропусков: «не выгрузилось», «клиент не заполнил», «ошибка парсинга» — это разные причины, и требуют они разных методов, поэтому одна фраза «есть пропуски» оценку не закрывает.
Шаг 2.1.2
Раскладываем признаки на три группы по доле пропусков. До 5% — заполнение медианой для числовых и модой для категориальных. От 5 до 40% — заполнение с индикатором пропуска и проверкой, не коррелирует ли сам факт пропуска с целевой. Больше 40% — столбец удаляем, предварительно записав это в журнал решений с обоснованием в одну фразу. Границы групп — рабочее соглашение, а не догма: важен не порог, а объяснение.
Второй критерий по пропускам — «решена проблема пропущенных значений», ещё 3 балла, и он измеримый: эксперт смотрит, что после обработки пустых ячеек действительно нет. Обоснование нужно, чтобы удаление столбца не выглядело способом спрятать сложность.
Журнал решений содержит строку на каждый признак с пропусками: доля, метод, причина. После обработки сумма пустых ячеек равна нулю, а число столбцов уменьшилось ровно на число удалённых, и это число названо в отчёте.
Заполнять всё средним без разбора: в зарплате и в возрасте распределения разные, и среднее по скошенному признаку тянет модель к центру. Вторая ошибка — удалять строки целиком: при 10% пропусков в пяти столбцах вы теряете почти половину выборки.
Проверяет обоснование по каждому удалённому столбцу: удаление признака с 60% пропусков — норма, удаление признака с 8% — вопрос, на который нужен внятный ответ, а не ссылка на удобство.
Шаг 2.1.3
Делаем заполнение не отдельной строкой над всем датафреймом, а шагом конвейера: SimpleImputer со стратегией median и add_indicator для числовых, most_frequent плюс отдельная категория unknown для категориальных. Всё это кладём в ColumnTransformer и вызываем fit только на обучающей части, чтобы медиана считалась по train, а не по всему набору. Параметр с индикатором важен: он сохраняет информацию о том, где данные были пустыми.
Конвейер из модуля А стоит 4 балла и требует, чтобы обработка воспроизводилась на новых данных одной командой. Заполнение, посчитанное по всему набору до разделения, — это утечка: медиана уже знает валидацию, и метрики в модуле С получаются завышенными на несколько процентов.
После fit_transform на обучающей части в выходе нет пустых значений, в imputer.statistics_ стоят числа, а не nan, число добавленных столбцов-флагов равно числу признаков с пропусками. Повторный fit на валидации не вызывается — только transform.
Заполнить пропуски до разделения выборок: модель обучается на статистиках, посчитанных по валидации, разрыв между train и valid исчезает, а вместе с ним и честная оценка качества. Вторая ошибка — заполнять категориальный признак медианой: pandas молча превратит столбец в строки с числом.
Смотрит порядок операций в коде: разделение раньше заполнения — правильно; заполнение раньше разделения — потеря баллов и за утечку, и за конвейер, причём сразу в двух критериях.
Шаг 2.1.4
Сравниваем распределение до и после заполнения: описательные статистики по ключевым признакам, квантили 5, 25, 50, 75 и 95, наложенную гистограмму до и после. Если заполнено меньше 5% значений, сдвиг должен остаться в пределах процента. Если больше — смотрим, не появился ли пик ровно в точке медианы, и если появился, пишем об этом отдельной строкой.
Это доказательство того, что пропуски решены, а не замаскированы: эксперт видит, что распределение не поехало после обработки. Тот же абзац закрывает оценочную часть критерия и объясняет, почему метрики модели выглядят именно так, а не иначе. Без такого сравнения заполнение выглядит удачным только на глаз.
Среднее и медиана после заполнения отличаются от исходных меньше чем на 2%, пиков на гистограмме в точке медианы нет. Число строк не изменилось, сумма пустых ячеек равна нулю, а число добавленных столбцов-индикаторов не превышает числа проблемных признаков.
Заполнить пропуски константой минус 999 «чтобы видно было»: среднее уезжает в минус, масштабирование растягивает шкалу, и модель считает это значение значимым. Вторая ошибка — не посмотреть на гистограмму и не заметить, что заполнение создало второй горб.
Смотрит наложенную гистограмму: два горба после заполнения — признак того, что пропуски не случайны, и об этом надо сказать словами, иначе участник не заметил главного в своих данных.
Действие 2.2. Привести типы данных в соответствие признакам
Шаг 2.2.1
Ищем числовые признаки, приехавшие строками: берём все столбцы типа object и по каждому смотрим первые десять значений, а затем пробуем to_numeric после замены пробелов, запятой на точку и удаления знаков рубля и процента. Считаем, сколько значений стало пустыми после приведения, — это и есть настоящие нечисловые вкрапления, их смотрим глазами по частотам.
Критерий про типы стоит 2 балла за определение и ещё 4 за исправление, причём второй измеримый: эксперт смотрит на dtypes после обработки. Строка вида «1 250,50 руб.» не считается числом ни в описательных статистиках, ни в корреляции, и половина модуля В просто не построится.
Типы для приведённых столбцов стали float64 или int64, а не object. Число пустых значений после приведения равно нулю или объяснено построчно: пустая строка, прочерк, «нет данных», — и по каждому случаю в отчёте есть отдельная строка.
Приводить через astype без предварительной очистки: одна строка с пробелом роняет весь столбец с ошибкой и вы теряете время на поиск иголки в стоге. Вторая ошибка — заменять запятую на точку без учёта разделителя тысяч: «1,250» превращается в 1.25 вместо 1250.
Открывает список типов и смотрит, что денежные и количественные признаки стали числами, а не остались строками с красивым форматированием и неразрывными пробелами внутри значения.
Шаг 2.2.2
Приводим даты через to_datetime с явно указанным форматом и параметром принудительного приведения, а не с угадыванием. После приведения печатаем минимум, максимум и число пустых дат, затем проверяем вменяемость диапазона: 1970 год и 2200-й — это ошибки разбора, а не данные. Из даты сразу делаем производные признаки: месяц, день недели, номер квартала.
Дата нужна как минимум для производных признаков, а без корректного типа их не построить. Плюс именно на датах чаще всего ломается соединение источников: в базе timestamp, в CSV строка в другом формате, и прямое сравнение даёт неверный отбор, который потом никто не замечает.
Тип стал datetime64, минимум и максимум попадают в ожидаемый период, число пустых дат равно числу битых значений, которые вы видели глазами. Производные признаки появились отдельными столбцами с типом int, а не object.
Оставить формат по умолчанию: «03.04.2024» прочитается как 3 апреля, а «04.03.2024» — тоже как 3 апреля, и часть дат молча перевернётся. Вторая ошибка — errors='ignore': столбец остаётся строками, а ошибка не видна до самого построения графика.
Смотрит минимум и максимум по датам: диапазон вне периода, указанного в задании, — прямой признак того, что формат не задан явно, и весь анализ по времени после этого недостоверен.
Шаг 2.2.3
Переводим текстовые категории в тип category, чтобы сразу увидеть уровни, а булевы признаки приводим к единому виду через map с явным словарём: да и нет, True и 1, Y и N — всё в единицы и нули. Всё, что не попало в словарь, печатаем и разбираем отдельно, а не оставляем пустым. Числа, которые на самом деле коды — регион, ОКВЭД, — оставляем строками.
Критерий исправления типов стоит 4 балла и проверяется по dtypes и по тому, сходится ли число уровней с реальностью. Код региона, прочитанный как число, при кодировании даст восемьдесят пять бессмысленных числовых значений вместо восьмидесяти пяти категорий.
Список уровней показывает осмысленные значения без опечаток и пробелов по краям, для булевых в столбце ровно два значения — ноль и единица. Ни в одном категориальном столбце нет дублей вида «Москва» и «москва».
Оставить «Москва», «москва» и «МОСКВА» разными уровнями: one-hot создаст три столбца вместо одного, и модель получит три слабых признака вместо одного сильного. Вторая ошибка — превратить код региона в число и потерять ведущий ноль у региона 02.
Проверяет кардинальность категорий: восемьдесят пять регионов вместо восьмидесяти пяти кодов — хорошо, девятьсот уровней вместо восьмидесяти пяти — признак неприведённых значений.
Действие 2.3. Определить шкалы и выполнить масштабирование
Шаг 2.3.1
По каждому количественному признаку печатаем describe с дополнительными квантилями 1, 25, 50, 75 и 99 и считаем выбросы по правилу полутора интерквартильных размахов: границы первый квартиль минус 1.5 IQR и третий плюс 1.5 IQR, число значений за границами и их долю. Таблицу «признак, минимум, максимум, квартили, выбросов, процент» вставляем в отчёт.
Определение шкал — первый шаг критерия на 5 баллов: без понимания разброса нельзя выбрать способ масштабирования. Признак с одним выбросом, который больше медианы в десять тысяч раз, после стандартизации превратит все остальные значения в точку у нуля.
Для каждого количественного признака записаны минимум и максимум, и вы можете словами сказать, физически ли они возможны: возраст 150 и сумма минус 5000 — нет. Число выбросов посчитано и сохранено до масштабирования, чтобы было с чем сравнить.
Масштабировать, не посмотрев на распределение: MinMaxScaler при выбросе в максимуме прижимает 99% данных к нулю, и график выглядит как одна вертикальная линия. Вторая ошибка — удалить выбросы, не записав, сколько их и по какому правилу.
Спрашивает, что участник сделал с выбросами: удалил, ограничил или оставил и взял робастное масштабирование — принимается любой ответ, если он обоснован.
Шаг 2.3.2
Выбираем преобразование под форму распределения: для близкого к нормальному — стандартизация, для требуемого диапазона от нуля до единицы — минимакс, при заметных выбросах — робастное масштабирование на медиане и интерквартильном размахе. Для скошенных денежных признаков сначала пробуем логарифм с прибавленной единицей, потом масштабируем результат.
Это те самые 5 баллов: эксперт смотрит не на факт вызова преобразователя, а на соответствие метода распределению. Логарифмирование скошенного признака часто даёт больше, чем любая нормализация: хвост подтягивается, и линейная модель начинает работать.
После стандартизации по обучающей выборке среднее каждого признака около нуля, а стандартное отклонение около единицы; после минимакса минимум ноль и максимум единица. Гистограмма логарифмированного признака стала симметричнее — сравните до и после.
Применить стандартизацию ко всем столбцам подряд, включая категориальные: получаются бессмысленные дробные категории и теряется интерпретация. Вторая ошибка — масштабировать целевую переменную и забыть вернуть её в исходные единицы при выводе метрик.
Просит назвать преобразователь и объяснить выбор одним предложением: «распределение скошено, поэтому робастное» — достаточный ответ, молчание или «взял первое из документации» — нет.
Шаг 2.3.3
Обучаем преобразователь только на обучающей части, затем применяем к обучающей и валидационной выборкам по отдельности. Параметры — средние, отклонения, медианы — сохраняем в отчёт как доказательство того, по какой выборке они посчитаны. В конвейере это делает сам Pipeline, и руками вызывать ничего не нужно. Порядок всегда один: обучение на train, применение к train, применение к valid.
Утечка через масштабирование — самая частая причина завышенных метрик в модуле С: если среднее посчитать по всем данным, валидация частично попадает в обучение. Плюс на защите спросят, по какой выборке считались статистики, и ответ «по всем» стоит баллов.
Число наблюдений, по которому посчитаны статистики, равно числу строк обучающей выборки, а не всего набора. После применения к валидации среднее не ровно ноль, а близко к нему — это нормально и подтверждает, что статистики взяты из обучающей части.
Вызвать преобразование на всём датафрейме и потом делить на выборки: метрики на валидации окажутся на несколько процентов выше честных, а на защите это заметят по подозрительно ровному результату на обучении и валидации.
Смотрит последовательность вызовов в коде: обучение на train, применение к valid — и только так. Любое обучение после разделения на данных валидации читается как утечка, даже если оно случайно не повлияло на метрики.
Действие 2.4. Перевести категориальные признаки в числовые
Шаг 2.4.1
По каждому категориальному признаку печатаем число уникальных значений и распределение частот по первым пятнадцати уровням. Считаем долю редких уровней — тех, что встречаются меньше чем в проценте строк, — и если таких больше двух десятков, объединяем их в отдельный уровень. Отдельно выписываем уровни с одним-двумя наблюдениями и решаем их судьбу. Правило объединения записываем, чтобы применить его же к валидации.
Критерий «определено количество уникальных значений» стоит 5 баллов и проверяется по таблице кардинальности. Признак с девятьюстами уровнями после кодирования даёт девятьсот столбцов, модель тонет в размерности, а сам признак остаётся почти бесполезным.
Для каждого категориального признака в отчёте стоит число уровней до и после объединения редких. Сумма долей после объединения равна единице, ни один уровень не потерялся молча, а правило объединения сохранено в коде, а не только на словах.
Кодировать признак с кардинальностью пятьсот: датафрейм вырастает в ширину, память кончается, а информативность падает. Вторая ошибка — объединять редкие уровни, не записав правило: на новых данных тот же уровень попадёт в другую группу.
Смотрит таблицу кардинальности: если в ней нет ни одного признака с большим числом уровней, возможно, участник взял не все категориальные признаки и потерял часть данных при соединении.
Шаг 2.4.2
Для номинальных признаков с числом уровней до пятнадцати берём one-hot с игнорированием неизвестных уровней и объединением редких по частоте, для порядковых — порядковое кодирование с явно заданным списком категорий в правильном порядке, для высокой кардинальности — целевое кодирование внутри кросс-валидации. В отчёт пишем, какой метод выбран для какого признака.
5 баллов за переход к числовым значениям даются за обоснованный выбор, а не за факт вызова функции. Игнорирование неизвестных уровней — страховка: на валидации может встретиться значение, которого не было в обучении, и без этого параметра преобразование падает с ошибкой.
Список имён выходных столбцов содержит префиксы исходных признаков, сумма столбцов на выходе равна сумме уровней по всем закодированным признакам. На валидации преобразование не падает и не создаёт пустых значений.
Порядковое кодирование на номинальном признаке: «Москва» становится нулём, «Уфа» — единицей, и модель решает, что Уфа больше Москвы. Вторая ошибка — one-hot без игнорирования неизвестных: первый же новый уровень в валидации роняет предсказание.
Проверяет, что для каждого категориального признака метод назван отдельно: один универсальный ответ «сделал get_dummies» на все случаи снижает оценку, потому что для высокой кардинальности он неверен.
Шаг 2.4.3
Собираем кодирование в ColumnTransformer: для числовых — цепочка из заполнения и масштабирования, для категориальных — цепочка из заполнения константой unknown и one-hot. Остаток отбрасываем явно и проверяем, что ни один нужный признак не выпал. Затем печатаем форму результата и имена столбцов, чтобы убедиться, что кодирование сработало. Порядок шагов внутри цепочек фиксирован и одинаков при обучении и применении.
ColumnTransformer — это и есть конвейер обработки данных, за который в модуле А дают 4 балла: все шаги в одном объекте, который обучается на train и применяется к новым данным. Он же снимает риск перепутать порядок столбцов между выборками, из-за которого предсказание падает на несовпадении размерности.
Число столбцов на выходе равно числу числовых признаков плюс сумма уровней категориальных, ни одна строка не потерялась, пустых значений нет. Имена столбцов читаемые, вида cat__region_Уфа, по ним потом можно строить важность признаков.
Кодировать категории отдельно через get_dummies до разделения выборок: на валидации набор столбцов другой, и модель падает на несовпадении размерности. Вторая ошибка — отбросить остаток молча и потерять признак, который в модель всё-таки нужен.
Открывает ColumnTransformer и проверяет, что в нём перечислены все шаги: заполнение, масштабирование, кодирование — именно в таком порядке, без пропусков и без дублей одного и того же преобразования.
Действие 2.5. Сохранить датафрейм и собрать конвейер
Шаг 2.5.1
Сохраняем предобработанный набор в parquet без индекса: parquet хранит типы, в отличие от CSV. Сразу читаем обратно и сравниваем форму и типы с исходными. Рядом кладём CSV с точкой с запятой и десятичной точкой, если задание требует именно его, и проверяем, что русские категории читаются без ромбиков и лишних кавычек. Имя файла — ровно то, что требует задание.
Сохранение в требуемом формате датафрейма — 1 балл, дешёвый, но теряется чаще всего: файл записан, а прочитать его обратно в том же виде нельзя. Проверка чтением — единственный способ убедиться, что типы, кодировка и разделитель не поехали, и что дальше работа пойдёт с тем же набором.
Форма и типы после повторного чтения совпадают с исходными, кодировка читается корректно, в папке нет файлов с суффиксами вида _new или _final2. Имя файла совпадает с тем, что требует задание, а путь к нему указан в отчёте.
Сохранять в CSV без отключения индекса: появляется безымянный столбец, и при следующем чтении он попадает в признаки. Вторая ошибка — не проверить обратное чтение: кодировка по умолчанию превращает категории в мусор, и обнаруживается это уже в модуле С.
Просит открыть сохранённый файл и показать, что он читается: сохранение без проверки считается несделанным, даже если файл формально существует и лежит в нужной папке.
Шаг 2.5.2
Оборачиваем всё в один объект: Pipeline из препроцессора и модели. Обучаем конвейер на сырых данных, а не на предобработанных, и проверяем эквивалентность: результат через конвейер совпадает с ручным результатом с точностью до третьего знака. Сохраняем объект в папку artifacts и указываем путь в отчёте. Проверку делаем на первых десяти строках, чтобы сравнение было быстрым.
4 балла за конвейер даются за то, что все шаги обработки воспроизводятся одной командой на новых данных. Это же защищает от главной ошибки при сдаче: модель обучена на одних столбцах, а предсказание подают другие, и вместо чисел получается ошибка размерности.
Результат через конвейер совпадает с ручным, загрузка сохранённого объекта возвращает тот же набор шагов, а predict на пяти строках сырых данных даёт числа без ошибок. В отчёте указан путь к файлу конвейера.
Собрать конвейер для отчёта, а модель обучить отдельно на предобработанном массиве: файлы расходятся, и при проверке конвейер выдаёт другие предсказания. Вторая ошибка — сохранять через pickle объекты с массивами: на другой версии библиотек файл не открывается.
Загружает сохранённый конвейер и подаёт ему сырую строку данных: если предсказание получается без ручной подготовки, конвейер настоящий, а не декоративный.
Задача 3. Модуль В: анализ, визуализация и ответы на частные вопросыМодуль В · 40 баллов
Полтора часа модуля В — это самая дорогая часть задания: сорок баллов против тридцати пяти и двадцати пяти в соседних модулях, и здесь же больше всего оценочных критериев, которые нельзя взять количеством. Требуются распределения по каждому признаку, описательные статистики вместе с модой и медианой, корреляция с выводами и диаграммами, ответы на вопросы работодателя через фильтрацию и группировки и отчёт, в котором всё это связано текстом. Порядок задан логикой: сначала форма распределений, потом числа, потом связи, потом частные вопросы.
Действие 3.1. Исследовать распределения признаков
Шаг 3.1.1
Строим сетку гистограмм по всем количественным признакам: фигура три на три с размером пятнадцать на десять дюймов, в цикле гистограмма с автоматическим числом корзин и белой обводкой столбцов, поверх — кривая плотности распределения. Оси подписываем с единицами измерения: сумма заказа в рублях, возраст в годах. Заголовок каждой панели — имя признака, а не «График 1».
Распределение признаков — 5 баллов, и это первый критерий модуля В: эксперт ищет графики по каждому количественному признаку, а не один общий. Форма распределения определяет следующий шаг обработки: логарифмировать, брать робастное масштабирование или оставить как есть.
На сетке столько панелей, сколько количественных признаков, ни одна не пустая. По каждой видна форма: один горб, два горба, длинный правый хвост. Файл сохранён в figs с разрешением не ниже 150 точек на дюйм.
Поставить десять корзин на признак с диапазоном в миллион: гистограмма выглядит как один столбик, и извлечь из неё нечего. Вторая ошибка — строить панели по признаку с пропусками без их отбрасывания: часть панелей падает с ошибкой, и сетка остаётся полупустой.
Смотрит, по всем ли признакам есть графики и подписаны ли оси: график без единиц измерения не отвечает на вопрос, что именно изображено, и оценивается ниже, чем аккуратная подпись при скромной палитре.
Шаг 3.1.2
Для категориальных признаков строим горизонтальные столбчатые диаграммы, отсортированные по частоте: так порядок сам рассказывает историю. Рядом с абсолютными числами печатаем доли в процентах, а при длинных подписях уровней уменьшаем размер шрифта и увеличиваем левое поле фигуры. Сумма столбцов равна числу непустых строк, а подписи уровней не обрезаны.
Диаграммы, визуализирующие выполненный анализ, — ещё 5 баллов: для категорий нужен именно подсчёт частот, гистограмма здесь бессмысленна. Сортировка сразу показывает перекос: если один уровень занимает 80%, модель будет угадывать большинство, и это надо видеть до обучения.
Сумма высот столбцов равна числу строк без пропусков, все уровни подписаны и читаются без увеличения. Перекос виден глазами и выражен в разах между первым и последним уровнем, а не в процентах, которые при сотне категорий ничего не говорят.
Строить вертикальные столбцы на тридцать категорий: подписи наезжают друг на друга и превращаются в чёрную полосу, эксперт не читает график и снижает оценку за качество диаграмм, даже если данные на них верные.
Оценивает читаемость: подписи не обрезаны, порядок осмысленный, единицы указаны — это и есть те 3 балла за качество, которые теряются чаще всего и восстанавливаются за десять минут.
Шаг 3.1.3
Для признаков с длинным правым хвостом строим второй график в логарифмической шкале, а рядом печатаем асимметрию и эксцесс: значения выше единицы по модулю означают заметную асимметрию. Вывод пишем словами, а не цифрой: «распределение суммы заказа правостороннее, медиана вдвое ниже среднего». Если после логарифма форма стала симметричной, фиксируем это отдельной строкой.
Критерий «исследовано распределение значений признаков» оценивается по выводу, а не по картинке: график без интерпретации — иллюстрация. Форма распределения напрямую влияет на выбор метрики: для скошенной целевой средняя абсолютная ошибка информативнее квадратичной.
Для каждого скошенного признака есть пара графиков — обычный и логарифмический — и численное значение асимметрии. В отчёте сказано, какие признаки после логарифмирования выровнялись, а какие остались скошенными.
Считать распределение нормальным, не посмотрев на асимметрию больше двух: потом удивляться, что модель систематически занижает крупные значения. Вторая ошибка — логарифмировать признак с нулями без прибавления единицы: получаются минус бесконечность и пустые ячейки.
Просит показать признак с ненормальным распределением и рассказать, что с ним сделано: умение видеть форму — половина оценки за анализ, и оно проверяется одним вопросом.
Действие 3.2. Вычислить и объяснить описательные статистики
Шаг 3.2.1
Считаем статистики через агрегацию по всем количественным признакам: количество, среднее, стандартное отклонение, минимум, максимум, медиана, дисперсия. Моду считаем отдельно, потому что в стандартной агрегации её нет, и добавляем её столбцом. Округляем до двух знаков, подписываем единицы измерения и сохраняем таблицу в figs для отчёта. Порядок столбцов — как в задании, чтобы эксперт сверял без поиска.
5 баллов за описательные характеристики: в задании перечислены экстремумы, среднее, мода, медиана и дисперсия, значит должны быть все пять, а не только стандартный набор из семи чисел. Мода и медиана нужны потому, что среднее по скошенному признаку обманывает.
В таблице ровно те столбцы, что перечислены в задании: минимум, максимум, среднее, мода, медиана, дисперсия, и дополнительно стандартное отклонение. Для категориальных признаков мода посчитана отдельно и названа самым частым уровнем.
Оставить только стандартное описание датафрейма: в нём нет моды, и критерий закрывается частично. Вторая ошибка — считать дисперсию по строкам с пропусками, не указав, что количество наблюдений меньше общего числа строк.
Сверяет список статистик с формулировкой задания: отсутствие моды — типичная потеря половины балла, а отсутствие дисперсии при наличии стандартного отклонения вопросов не вызывает.
Шаг 3.2.2
По каждому ключевому признаку сравниваем среднее и медиану: если среднее заметно больше медианы, распределение смещено вправо, и в отчёте пишем именно это, а не «среднее значение равно икс». Для категориальных смотрим разброс частот: какой уровень доминирует и во сколько раз. Дисперсию переводим в стандартное отклонение — оно в тех же единицах, что и сам признак.
Оценочная часть баллов за статистику ставится за интерпретацию, а не за таблицу: эксперт читает выводы и проверяет, понимает ли участник, что значат числа. Стандартное отклонение в рублях понятнее дисперсии в рублях в квадрате, и это видно по тексту отчёта.
В отчёте по каждому из трёх-четырёх главных признаков есть фраза с числом и объяснением: медиана 1200 рублей при среднем 3400 говорит о хвосте крупных заказов. Числа в тексте совпадают с таблицей статистик.
Написать «данные имеют нормальное распределение» без проверки: при асимметрии три это неправда, и следующий шаг — корреляция Пирсона — считается на неподходящих данных, а выводы по ней расходятся с реальностью.
Смотрит на совпадение цифр в тексте и в таблице: расхождение читается как переписанный чужой вывод, и после этого весь раздел аналитики проверяется с пристрастием.
Шаг 3.2.3
Считаем те же статистики в разрезе целевой переменной или ключевой категории: группировка с описанием по каждой группе и сравнение медиан. Если медианы групп различаются в разы, признак информативен и его стоит тащить в модель. Результат оформляем парными коробчатыми диаграммами по группам, не скрывая выбросы и размеры групп. Разрез делается один раз и потом идёт в отчёт как первый признак сигнала.
Такой разрез — самый быстрый способ увидеть, есть ли в данных сигнал вообще, ещё до построения модели. Он же подпирает баллы за анализ: эксперт видит, что участник не просто посчитал статистики, а сравнил их между группами и сделал из сравнения вывод.
В таблице по группам видны количество, среднее и медиана, а разница медиан сформулирована в разах. Коробчатая диаграмма сохранена, выбросы на ней показаны, а не вырезаны, и размеры групп подписаны под графиком.
Сравнивать средние при сильно разном размере групп: маленькая группа из трёх записей даёт «среднее», которое ничего не значит. Вторая ошибка — не смотреть на количество и делать вывод по группе из двух строк.
Спрашивает, чем группы отличаются: если участник называет разницу медиан и размеры групп, разрез сделан осмысленно, а если только показывает график — нет.
Действие 3.3. Исследовать корреляцию и показать её графически
Шаг 3.3.1
Перед расчётом выбираем метод: для линейной связи нормально распределённых признаков — Пирсон, для ранговых зависимостей и данных с выбросами — Спирмен. Обоснование пишем в отчёт одной фразой: признаки скошены и содержат выбросы, поэтому берём ранговую корреляцию. Считаем обе матрицы и сравниваем пары, где расхождение по модулю больше 0.2. Разницу в методах объясняем через выбросы и форму распределения.
5 баллов за исследование корреляционных зависимостей даются за обоснованный метод и выводы, а не за тепловую карту. Пирсон на скошенных данных занижает связь или ловит её там, где её нет, из-за единственного выброса в углу облака, и вывод по такой матрице уводит в сторону.
Матрица квадратная, диагональ равна единице, симметрия соблюдена. Для пар, где два метода расходятся больше чем на 0.2, в отчёте есть объяснение, какой метод ближе к правде и почему, — это и показывает, что считали осознанно.
Считать корреляцию по категориальным признакам, закодированным one-hot: коэффициенты получаются бессмысленными и мешают искать настоящие связи. Вторая ошибка — включать в матрицу идентификаторы и даты.
Проверяет, назван ли метод и почему: матрица без обоснования стоит половину балла, потому что непонятно, можно ли ей верить на этих данных. Если ответа нет, непонятно, можно ли верить всей матрице.
Шаг 3.3.2
Строим тепловую карту корреляций: размер фигуры не меньше двенадцати на десять дюймов, верхний треугольник маскируем, значения подписываем двумя знаками после запятой, цветовую шкалу фиксируем в диапазоне от минус единицы до единицы. Подписи признаков поворачиваем на сорок пять градусов, чтобы они читались. Сохраняем в figs с разрешением 150. Такую карту строят один раз и вставляют в отчёт без правок.
5 баллов за диаграммы, визуализирующие корреляцию: маска убирает дублирующий треугольник, а фиксированный диапазон не даёт цвету обманывать. Без фиксации диапазона слабая связь 0.3 выглядит почти как сильная, и вывод по карте получается ровно противоположным данным.
На карте видны числа, подписи не обрезаны, цветовая шкала подписана и симметрична относительно нуля. Диагональ скрыта маской, чтобы единицы не перетягивали внимание и не искажали восприятие цветов. Подписи признаков читаются под углом без наклона головы.
Строить карту на шестидесяти признаках без отбора: подписи сливаются в кашу, график нечитаем, и теряются 3 балла за качество диаграмм. Вторая ошибка — оставить цветовую шкалу автоматической: тогда карта показывает не силу связи, а разброс внутри набора.
Открывает карту и проверяет читаемость: если подписи не разобрать, график не защитан как качественный, и три балла за оформление теряются вместе с частью баллов за визуализацию.
Шаг 3.3.3
Из матрицы выписываем пары с коэффициентом больше 0.7 по модулю и для каждой решаем, какой признак оставить: тот, что сильнее связан с целевой, или тот, что проще интерпретировать. Для спорных случаев считаем фактор инфляции дисперсии, значения выше десяти — повод убрать. Решение по каждой паре фиксируем в отчёте отдельной строкой. Для каждой пары важно понять, какой признак первичен по смыслу.
Выводы по корреляции — отдельная часть баллов: нужно не показать числа, а сказать, что они означают для модели. Два сильно коррелирующих признака дают неустойчивые коэффициенты линейной регрессии, и знак коэффициента может перевернуться, что выглядит как ошибка анализа.
Для каждой пары с коэффициентом выше 0.7 в отчёте есть строка «оставлен признак такой-то, потому что». Набор признаков в модуле С совпадает с тем, что записано здесь, а не отличается на два-три столбца.
Оставить оба коррелирующих признака и потом удивляться отрицательному коэффициенту у признака, который с целевой связан положительно. Вторая ошибка — удалять коррелирующие признаки, не проверив их связь с целевой, и терять самый информативный.
Сверяет список признаков в отчёте с тем, что подано в модель: расхождение в два-три столбца — признак того, что выводы писались отдельно от работы, и повод спросить, какой из списков настоящий.
Шаг 3.3.4
Для трёх пар с наибольшей связью строим диаграммы рассеяния с линией тренда: точки мелкие и полупрозрачные, чтобы была видна плотность облака. Если признак скошен, ставим логарифмическую шкалу по соответствующей оси. Линия тренда показывает направление связи, а не предсказывает значение, и подписываем её именно так. Такие графики лучше строить по одному на фигуру, а не сеткой: на сетке мелкие детали теряются.
Корреляция Пирсона ловит только линейную связь, и диаграмма показывает, есть ли она вообще: часто точки лежат облаком, а коэффициент 0.4 получается из-за нескольких выбросов в углу. Это те самые баллы за визуализацию зависимостей между данными, и без картинки они не набираются.
На каждом графике видна форма облака и линия тренда, выбросы показаны, а не отфильтрованы молча. Подписи осей с единицами, точки не сливаются в сплошной прямоугольник, а плотность читается по оттенку.
Строить рассеяние с крупными непрозрачными точками на пятидесяти тысячах строк: получается чёрный прямоугольник, из которого не видно ни формы, ни направления связи, и график не защитывается. Прозрачность и размер точки — не украшение, а способ увидеть плотность.
Смотрит, соответствует ли картинка коэффициенту: если связь 0.75, а облако круглое, значит матрица считалась по другим данным или после фильтрации строк.
Действие 3.4. Ответить на частные вопросы работодателя
Шаг 3.4.1
Каждый вопрос из задания переводим в явное условие фильтрации: например, заказы дороже пяти тысяч рублей за второй квартал в конкретном регионе. Условия записываем отдельными переменными и после каждого шага печатаем, сколько строк осталось. Сложные условия разбиваем на последовательные шаги, а не пишем одной строкой, иначе ошибку в логике не найти.
Ответы на частные вопросы стоят 5 баллов и проверяются по числам: эксперт сравнивает ваш ответ с эталонным. Ошибка в границах периода — включительно или нет — даёт другой ответ, даже если код логически верный и читается хорошо. Поэтому границы периодов выписываем в тексте ответа, а не держим в голове.
После фильтрации число строк уменьшилось, и вы можете объяснить, за счёт какого условия. Выборочно проверьте три-пять строк глазами, а сумму по отфильтрованным данным сверьте с ручным расчётом по тем же строкам.
Сравнивать даты строками: условие работает только для формата год-месяц-день, а после приведения к дате строка уже не сравнивается. Вторая ошибка — забыть скобки в составном условии и получить совсем не тот набор строк.
Просит показать промежуточные количества строк: без них ответ нельзя проверить, и балл снижается, даже если итоговое число совпало с эталоном случайно.
Шаг 3.4.2
Считаем группировки с именованными агрегатами: по каждой группе среднее, минимум, максимум, сумму и количество. Сортируем по сумме и строим горизонтальную столбчатую диаграмму, где подписаны и сумма, и количество записей. Средний чек считаем как сумму, делённую на количество, а не как среднее от средних. Пять агрегатов — ровно те, что перечислены в задании.
В задании прямо перечислены пять агрегатов — среднее, минимум, максимум, сумма и количество, — и каждый оценивается отдельно. Среднее от средних по группам разного размера даёт неверный ответ на вопрос, и это классическая ошибка, которую эксперт ищет первым делом.
Сумма по всем группам равна общей сумме по набору, сумма количеств равна числу отфильтрованных строк. Средний чек, посчитанный делением суммы на количество, отличается от среднего от средних, и вы понимаете, почему.
Брать среднее от уже сгруппированных средних: при группах разного размера результат смещается в сторону маленьких групп, и ответ расходится с эталоном на десятки процентов, а найти эту ошибку в тексте почти невозможно.
Проверяет сходимость итогов: сумма по группам равна общему итогу — базовый тест на корректность агрегации, который занимает у эксперта минуту и сразу показывает уровень аккуратности.
Шаг 3.4.3
Каждый вопрос закрываем отдельным абзацем: сначала ответ одним числом, потом расшифровка — за какой период, по какому фильтру, сколько записей в основе. Под ответом ставим график, на который текст ссылается. Если в основе ответа меньше тридцати записей, пишем это прямо, а не выдаём число за закономерность. По каждому вопросу отдельный абзац, а не общий список чисел в конце раздела.
Оценочные баллы за ответы ставятся по тексту: число без контекста проверить нельзя, а фраза «самый прибыльный регион — такой-то» без суммы и периода не является ответом. Оговорка про малые группы показывает зрелость анализа и тоже входит в оценку. Ответ без контекста не принимается ни на защите, ни в реальной работе.
По каждому вопросу из задания есть абзац с числом, фильтром и количеством записей. Все числа в тексте сходятся с выводом ячеек, а не переписаны вручную, и по каждому ответу можно воспроизвести расчёт за одну минуту.
Ответить «примерно 1200» без точного числа и без указания, что суммировалось: такой ответ не зачитывается, потому что его нельзя проверить. Вторая ошибка — дать число без периода: за другой квартал ответ будет другим.
Берёт ваш ответ и пересчитывает одним запросом: расхождение больше нескольких процентов — вопрос не зачтён, потому что причина почти всегда в неверном фильтре или в среднем от средних.
Действие 3.5. Собрать отчёт по модулю и оформить графики
Шаг 3.5.1
Собираем отчёт одним документом: титул с компетенцией и категорией, раздел описания данных с паспортом, раздел предобработки с журналом решений, раздел анализа с графиками и выводами, раздел ответов на вопросы и резюме на пять-семь предложений. Каждый рисунок получает подпись «Рис. N. Что показано» и ссылку в тексте. Разделы идут в том же порядке, что модули задания.
Оформленный отчёт — 4 балла, качественно оформленный — ещё 3, и это два отдельных критерия, хотя оба зависят от одного документа. Отчёт без ссылок на рисунки читается как набор картинок, а эксперт ищет по тексту, где именно вы обсуждаете показанный график, и не находит.
Оглавление совпадает с разделами, все рисунки пронумерованы и упомянуты в тексте, таблицы подписаны. Отчёт читается с начала до конца без обращения к ноутбуку, и по нему можно повторить все расчёты. Ни один рисунок не остаётся без ссылки в тексте.
Сдать ноутбук вместо отчёта: ячейки с выводом вперемешку с кодом эксперт не читает как аналитический отчёт, и 4 балла превращаются в часть. Вторая ошибка — резюме без чисел: общие слова о проделанной работе не зачитываются.
Оценивает отчёт как документ: структура, подписи, связность текста — это и есть 3 балла за качество, и они снимаются первыми, когда отчёт собран из кусков ноутбука.
Шаг 3.5.2
Приводим все рисунки к одному стилю: одинаковое разрешение, единый размер шрифта от одиннадцати до двенадцати пунктов, одна палитра, заголовки и подписи осей с единицами. Убираем лишние рамки и сетку-клетку, длинные подписи переносим на две строки. Каждый график сохраняем отдельным файлом и вставляем в отчёт в том же порядке. Стиль задаём один раз через параметры по умолчанию.
3 балла за качество диаграмм — оценочные, и ставятся они за читаемость: подписанные оси, легенда, отсутствие обрезанных подписей. Мелкий шрифт и десять цветов на одном графике читаются как небрежность, даже если данные на нём корректны и выводы верные.
Откройте отчёт в масштабе 100%: все подписи читаются без увеличения, ничего не обрезано по краям, цвета последовательны между графиками. Все изображения вставлены файлами, а не скриншотами интерфейса.
Вставить скриншоты из ноутбука: на них видны полосы прокрутки и серый фон, размер шрифта не контролируется — прямой минус за качество оформления. Вторая ошибка — обрезать подписи при сохранении: часть названий категорий пропадает.
Смотрит на один-два графика внимательно: читаемость подписей — самый быстрый индикатор уровня оформления всего отчёта, и по нему эксперт решает, сколько времени тратить на остальное.
Задача 4. Модуль С: обучение модели, метрики, вывод и сохранениеМодуль С · 25 баллов
Последние полтора часа — пять критериев по пять баллов, и все они измеримые: данные разделены на обучающую и валидационную части, модель обучена, метрики вычислены, вывод сделан, файл сохранён. Здесь нельзя выиграть оформлением, зато легко потерять всё разом: если разделение сделано после предобработки или гиперпараметры подбирались по валидации, оценка качества перестаёт быть честной. Поэтому порядок жёсткий: сначала делим, потом обучаем, потом считаем и только в конце сохраняем.
Действие 4.1. Разделить данные и защититься от утечки
Шаг 4.1.1
Делим набор на обучающую и валидационную части: двадцать пять процентов на валидацию, фиксированный random_state и стратификация по целевой для классификации. Для регрессии стратификация не нужна, но полезно проверить, что квантили целевой в обеих частях совпадают. Разделение делаем до любого обучения преобразователей, а не после. Это первое действие модуля С, и оно задаёт порядок всем остальным.
5 баллов за разделение данных — самый дешёвый и самый пропускаемый критерий: участники делят данные где-то в середине, уже после масштабирования. Пропорция 75 на 25 даёт достаточно строк для обучения и статистически устойчивую оценку на валидации. Меньшая валидация даёт шумные метрики, большая отнимает данные у модели.
Сумма размеров двух частей равна числу строк набора, доли классов в обеих частях отличаются меньше чем на один процентный пункт, квантили целевой близки. В коде разделение стоит раньше любого обучения преобразователей, и это видно по номерам ячеек.
Разделить без фиксированного random_state: при повторном запуске выборки другие, и цифры в отчёте не воспроизводятся, а эксперт не может проверить метрики. Вторая ошибка — отдать под валидацию пять процентов: оценка на сотне строк слишком шумная.
Смотрит, где в коде стоит разделение относительно предобработки: до — правильно, после — вопрос об утечке, и ответ «я потом пересчитал» принимается только с повторным прогоном.
Шаг 4.1.2
Проверяем представительность выборок: печатаем доли классов в обучающей и валидационной частях рядом, для регрессии — описательные статистики целевой в обеих. Если в валидации встретился класс, которого нет в обучении, стратификация не сработала. Результат оформляем маленькой таблицей: выборка, размер, доля класса или медиана целевой. Таблица идёт в отчёт первой в модуле С.
Разделение оценивается не фактом вызова функции, а тем, что выборки сопоставимы: баллы снимаются, если валидация состоит из одного класса или из крайних значений целевой. Таблица сравнения — доказательство корректности, которое эксперт проверяет за десять секунд.
Размеры соотносятся как 75 к 25 с точностью до одной строки, доли классов совпадают, медиана целевой отличается не больше чем на пять процентов. Числа в таблице совпадают с выводом ячеек, а не взяты из предыдущего прогона.
Отложить валидацию первыми строками файла: если данные отсортированы по дате, вы обучитесь на прошлом и проверитесь на будущем, а метрики будут выглядеть прилично и обманут вас же при защите. Сортировка по ключу или по дате — самая частая причина такого провала.
Просит показать сравнение распределений: совпадение — признак того, что разделение сделано осознанно, а не первой попавшейся функцией из документации.
Шаг 4.1.3
Ещё раз фиксируем порядок операций: все преобразователи обучаются на обучающей части, а к валидации применяются только через transform или predict. Если работаете без конвейера, проверьте, что средние и категории посчитаны по обучающей выборке. В отчёт пишем одну строку: статистики предобработки рассчитаны на обучающей выборке. Эту фразу эксперт ищет в тексте, поэтому она должна быть дословной.
Это защита от утечки, из-за которой метрики на валидации получаются лучше реальных на несколько процентов. Эксперт в модуле С смотрит именно на это: модель, обученная на данных, включающих валидацию, не зачитывается как обученная корректно, даже при красивых числах.
В коде нет ни одного обучения преобразователя на полном наборе или на валидации, предсказание проходит без предупреждений о несовпадении признаков. Метрики на валидации ниже, чем на обучении, — нормальный признак отсутствия утечки.
Сделать преобразование на всём наборе и потом разделить: коэффициент детерминации на валидации почти равен обучению, и именно это должно настораживать, а не радовать, потому что честная модель так себя не ведёт.
Ищет в коде обучение преобразователей до разделения: находит — снимает баллы и за разделение, и за обучение, потому что оба критерия оказываются невыполненными по существу.
Действие 4.2. Обучить заданную модель
Шаг 4.2.1
Берём модель, заданную в конкурсном задании: для классификации — логистическая регрессия с достаточным числом итераций и учётом дисбаланса классов, для регрессии — линейная или гребневая с регуляризацией. Как второй вариант для нелинейных зависимостей добавляем случайный лес с фиксированным random_state. Выбор обосновываем в отчёте тремя предложениями: тип целевой, линейность связи, число признаков.
Обученная модель — 5 баллов, но балл ставится за модель, соответствующую задаче: регрессия на категориальной целевой не зачитывается. Учёт дисбаланса нужен, иначе при перекосе 90 на 10 модель просто предсказывает большинство и показывает красивую точность.
Тип модели совпадает с типом задачи в задании, предсказание возвращает значения того же типа, что целевая: классы или непрерывные числа. Обоснование в отчёте занимает хотя бы три предложения и упоминает признаки, а не только название алгоритма.
Обучить классификатор на непрерывной целевой: библиотека выдаст предупреждение, а метрики получатся бессмысленными. Вторая ошибка — взять сложную модель «чтобы качество было выше» без обоснования: эксперт спросит, почему не линейная, и ответа не будет.
Спрашивает, почему выбрана эта модель: ответ «так указано в задании» принимается, «не знаю» — нет, а ссылка на тип целевой переменной считается лучшим ответом.
Шаг 4.2.2
Обучаем конвейер на обучающей части с замером времени. Если нужна настройка гиперпараметров, делаем перебор по небольшой сетке с кросс-валидацией на пяти фолдах и только по обучающей выборке, в качестве метрики указывая ту же, по которой потом будем отчитываться. После обучения печатаем число итераций, лучшие параметры и число признаков на входе модели.
Кросс-валидация на обучающей части — единственный способ подобрать параметры, не заглядывая в валидацию. Пять фолдов дают устойчивую оценку, а перебор по четырём значениям регуляризации занимает секунды и почти всегда добавляет качества. Сетка должна быть маленькой: широкий перебор съедает время модуля.
Модель обучена, время укладывается в отведённые модулю полтора часа с запасом, лучшие параметры зафиксированы в отчёте. Валидационная выборка при подборе не использовалась, и это видно по коду, а не только по вашим словам.
Подбирать гиперпараметры по валидационной выборке: она перестаёт быть независимой, итоговая метрика завышена, и на защите это ловится вопросом, сколько раз вы смотрели на валидацию. Правильный порядок — подбор только на обучающей части, валидация один раз в конце.
Смотрит, использовалась ли валидация при подборе: если да, оценка качества не принимается, потому что числа потеряли смысл независимой проверки. Проверка занимает один вопрос, и он задаётся почти всегда.
Шаг 4.2.3
Проверяем, что модель действительно обучилась: предсказание на пяти строках обучающей и валидационной частей, отсутствие пустых значений и бесконечностей в выходе. Для линейных моделей смотрим коэффициенты — нет ли значений порядка миллиона, для деревьев — важность признаков. Для классификации печатаем распределение предсказанных классов. Все три проверки занимают две минуты.
Это дешёвая проверка на формально обученную модель: коэффициенты в миллион и одинаковые предсказания — признаки невылеченных выбросов или немасштабированных признаков. Проверка занимает минуту, а спасает половину модуля С, который иначе сдаётся с бессмысленными метриками.
В предсказаниях нет пустых значений, диапазон физически возможен, доли предсказанных классов не равны ста процентам одному классу. Коэффициенты линейной модели сопоставимы по порядку, а не различаются в тысячу раз.
Не заметить, что после кодирования остались признаки в рублях без масштабирования: коэффициенты получаются порядка 10 в минус пятой и 10 в третьей рядом, и интерпретация теряет смысл, а модель становится неустойчивой.
Просит показать предсказания на нескольких строках: живая модель видна по осмысленным числам, а модель, выдающая константу, видна по одинаковым значениям подряд.
Действие 4.3. Вычислить метрики и сделать вывод о качестве
Шаг 4.3.1
Считаем метрики под задачу. Для регрессии — средняя абсолютная ошибка, корень из среднеквадратичной, коэффициент детерминации и средняя абсолютная ошибка в процентах. Для классификации — точность, полнота, F-мера и площадь под ROC-кривой, плюс полный отчёт по классам. Каждую метрику считаем отдельно на обучении и на валидации и печатаем парами. Единицы измерения указываем рядом с каждым числом.
Вычисленные метрики — 5 баллов, и они должны быть именно те, что заданы в конкурсном задании. Коэффициент детерминации без абсолютной ошибки не говорит, насколько велика ошибка в рублях, а точность при дисбалансе 90 на 10 выглядит красиво и не значит ничего.
Для каждой метрики есть пара значений — обучение и валидация, единицы понятны: рубли для абсолютных ошибок, проценты для относительной, доли для детерминации и F-меры. Деления на ноль в относительной ошибке нет — проверьте целевую на нули.
Считать только точность при дисбалансе классов: модель, предсказывающая большинство, даёт девяносто процентов и ноль пользы, а эксперт видит это по матрице ошибок сразу и снимает баллы за вывод. Полнота и F-мера показывают то, что скрывает точность.
Сверяет список метрик с заданием: отсутствие заданной метрики — прямой минус, лишние метрики минусом не считаются, а метрика, посчитанная только на обучении, не считается вовсе.
Шаг 4.3.2
Сравниваем обучение и валидацию: разница в коэффициенте детерминации больше 0.1 или падение F-меры больше десяти процентов — признак переобучения, и об этом надо написать, а не спрятать. Дополнительно считаем базовую линию: для регрессии — предсказание медианой обучающей выборки, для классификации — мажоритарный класс. Модель должна быть заметно лучше этой линии.
Вывод о качестве модели — 5 баллов, и он ставится за честную интерпретацию, включая признание переобучения. Сравнение с базовой линией отделяет «модель работает» от «данные такие, что и константа даёт неплохой результат», и без него вывод неубедителен.
В отчёте есть таблица из двух строк — обучение и валидация — и отдельная строка базовой линии. Разрыв между обучением и валидацией назван числом и объяснён: мало данных, много признаков, шумная целевая.
Показать только метрику на обучении и умолчать о валидации: это читается как попытка скрыть переобучение, и оценочные баллы снимаются вместе с измеримыми, хотя формально числа есть. Сравнение должно быть явным: две строки в таблице, а не одно число в тексте.
Задаёт вопрос, почему на валидации хуже: готовый ответ с числом и причиной — признак понимания, молчание — признак того, что таблицу заполняли не глядя.
Шаг 4.3.3
Строим диагностические графики. Для регрессии — диаграмму «предсказание против факта» с диагональю равных значений и график остатков против предсказаний. Для классификации — матрицу ошибок и ROC-кривую с подписанной площадью. Графики сохраняем в figs и вставляем в отчёт с подписью, что именно они показывают. Оба графика строятся на валидационной выборке, а не на обучающей.
Диаграммы, визуализирующие выполненный анализ, — отдельные баллы, и именно они показывают, где модель ошибается: систематическое смещение на крупных значениях видно на остатках, но не в числе коэффициента детерминации. Одна картинка здесь стоит больше страницы текста.
На графике «предсказание против факта» точки лежат вокруг диагонали без выраженного изгиба, остатки распределены вокруг нуля без воронки. У ROC-кривой подписана площадь, и она совпадает с числом из таблицы метрик.
Показать только гистограмму остатков: она не выявляет разброс, растущий с уровнем предсказания, — воронку видно лишь на графике остатков против предсказаний, и диагноз остаётся неполным. Диагностика без второго графика остаётся неполной.
Смотрит на остатки: воронка или изгиб — повод спросить, пробовал ли участник логарифмировать целевую, и по ответу видно, понимает ли он, что происходит с моделью.
Шаг 4.3.4
Пишем вывод о целесообразности в три-четыре предложения: метрика на валидации с числом, сравнение с базовой линией, ограничения — какие группы предсказываются хуже, какой диапазон значений не покрыт данными, — и рекомендация: использовать, дообучить или собрать больше данных. Вывод не должен противоречить таблице метрик и пишется последним. Формулировки держим короткими и проверяемыми.
Критерий «сделан вывод о качестве обученной модели» — 5 баллов, и он оценочный: оценивается связность и честность вывода. Фраза «модель показала хорошее качество» без числа и без ограничений не зачитывается, потому что её нельзя ни проверить, ни использовать.
В выводе есть минимум одно число с единицей измерения, одно ограничение и одна рекомендация. Числа совпадают с таблицей и графиками, а ограничения следуют из того, что видно на остатках или в матрице ошибок.
Закончить словами «модель пригодна для использования» без указания условий: это не вывод, а лозунг, и оценочный балл снимается целиком, потому что проверить такое утверждение невозможно. Вывод должен быть таким, чтобы его можно было проверить по таблице.
Читает вывод последним и сверяет с цифрами: противоречие между текстом и таблицей — самый частый повод снизить оценку, а ограничения, названные самим участником, наоборот, её повышают.
Действие 4.4. Сохранить модель и сдать работу
Шаг 4.4.1
Сохраняем модель в требуемом формате: конвейер целиком через joblib или pickle с явно указанным протоколом, плюс отдельный JSON с метаданными — список признаков в порядке подачи, версии библиотек, метрики на валидации, дата и значение random_state. Имя файла — ровно то, что требует конкурсное задание, без приписок вида final. Путь к файлу и его имя дублируем в отчёте и в чек-листе сдачи.
Сохранённая модель — 5 баллов, и проверяется она загрузкой: файл, который не открывается на другой машине, баллов не приносит. Метаданные нужны потому, что модель без списка признаков и версий не воспроизводится, а через месяц её невозможно ни переобучить, ни объяснить.
Загрузка возвращает объект с методами предсказания и преобразования, предсказание на пяти строках даёт те же числа, что до сохранения, — сравните через allclose. JSON с метаданными открывается и содержит все перечисленные поля.
Сохранить только модель без препроцессинга: на новых данных предсказание падает на несовпадении числа признаков, а восстановить порядок столбцов уже нечем. Вторая ошибка — сохранить в рабочую папку, которую не сдают: файл есть, но эксперту его не покажут.
Загружает ваш файл и делает предсказание: если получается, модель сохранена правильно, а если требуется ещё что-то дообучить руками — значит, сохранён не тот объект.
Шаг 4.4.2
Проходим финальный чек-лист по критериям задания: модуль А — подключение, извлечение, структура, пропуски, типы, масштабирование, категории, конвейер, сохранение; модуль В — распределения, статистики, корреляция, диаграммы, ответы, отчёт; модуль С — разделение, обучение, метрики, вывод, сохранение. Каждый пункт отмечаем с номером ячейки, где он реализован, и сдаём работу в отведённое окно.
Чек-лист по критериям — самый быстрый способ найти потерянные баллы: обычно не хватает двух-трёх пунктов, которые закрываются за пять минут. Сдать нужно до конца модуля: работа принимается в том виде, в котором её застали, и дополнительного времени не дают.
Все пункты критериев отмечены и найдены в ноутбуке, повторный запуск сверху вниз проходит без ошибок, сохранённые файлы на месте. Время сдачи укладывается в окно плюс-минус пять минут, и работа сдана в том виде, в котором её проверяли.
Оставить проверку на последние минуты: запуск сверху вниз находит ошибку в первой ячейке, исправлять её уже некогда, и работа сдаётся в нерабочем виде — теряется всё, что было сделано за четыре с половиной часа.
Проверяет по своему чек-листу и ищет именно отсутствующие пункты: полный комплект файлов и отчёта — половина успеха, потому что баллы за отсутствующий файл не начисляются вообще.
Специалист
работающие профессионалыВ официальном файле категории не разделены отдельными разделами — приводим задание целиком; различия по категориям смотрите в таблице модулей.
Пошаговое решение
Задание для специалистов по компетенции «Машинное обучение и большие данные» разбито на три модуля по 1 часу 40 минут: сбор и предобработка данных, анализ и визуализация, использование данных для обучения моделей. Общее время — 5 часов, максимум — 100 баллов, из них 35 даёт модуль А, 35 модуль В и 30 модуль С. По заданию нужно собрать данные из нескольких источников в один пригодный для задачи набор, обучить не менее двух моделей, оценить их качество и сделать вывод о перспективах применения, а все шаги отразить в отчёте с графиками. Ниже — путь от первого подключения к базе до сохранённой модели, с инструментами и типичными ошибками на каждом шаге.
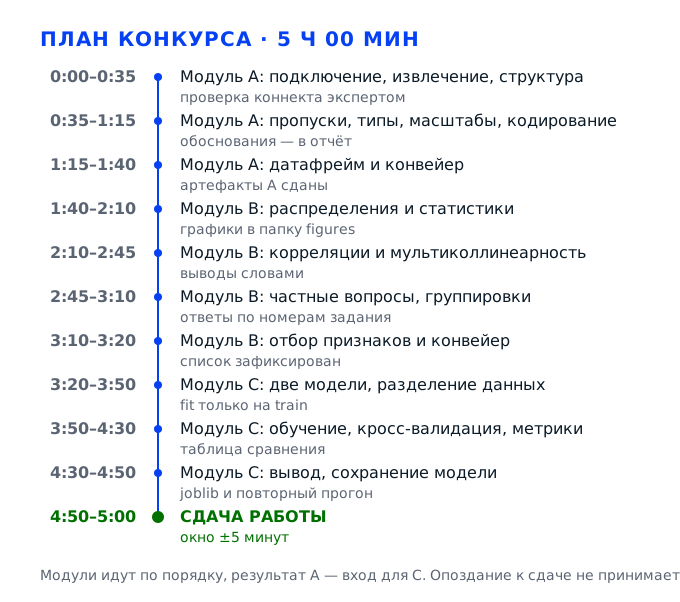
Задача 1. Подключиться к источникам и собрать из них единый набор данныхМодуль А · 35 баллов
Модуль А у специалистов длится 1 час 40 минут и даёт 35 баллов из 100, причём результат этого модуля — фундамент для двух следующих: модели в модуле С учатся ровно на том датафрейме, который вы соберёте здесь. Задание требует подключиться к источнику, извлечь структурированную информацию из нескольких источников, описать структуру и наименования признаков. Отдельные баллы стоят за само подключение (2), за сформированный набор (5) и за описание структуры (1), поэтому сначала налаживаем доступ и только потом думаем про статистику.
Действие 1.1. Наладить подключение к источникам
Шаг 1.1.1
Открываем рабочую папку с номером участника и первым делом читаем инфраструктурный лист площадки: там перечислены адреса источников, логины, имена баз и пути к файловым хранилищам. Выписываем список источников с типом каждого: база, csv, json или веб-ресурс. Рядом отмечаем, какую сущность берём оттуда. Проверяем доступность до всякой аналитики: терминал, ping до хоста и psql -h <хост> -U <логин> -c 'select 1' для базы, обычный запрос в браузере для веб-ресурса.
Два балла за подключение — самые дешёвые в модуле, но теряют их чаще всего: участник сразу садится писать код, а на двадцатой минуте выясняется, что база слушает другой порт или пароль выдан в другом регистре. Пока доступ не подтверждён командой, любая работа с данными остаётся предположением, а критерий «Выполнено подключение к источнику данных» эксперту показывать нечем.
Убедитесь, что по каждому источнику получен конкретный ответ: для базы — таблица с единицей, для файла — размер в байтах и первая строка, для веб-ресурса — код 200 и фрагмент тела. Если ответа нет, идём к техническому эксперту сразу, а не после третьей попытки.
Классическая ошибка — начать с ноутбука и подключить источник «по памяти», с прошлогодними реквизитами: соединение падает, а участник тратит время на перебор портов вместо работы. Вторая — проверить только один источник из трёх и обнаружить пропущенный ближе к концу модуля, когда перечитывать данные уже нет времени.
Эксперт подходит в первые десять минут и смотрит, открыт ли у участника рабочий коннект и сохранён ли он в отдельном конфигурационном файле, а не набран вручную в ячейке.
Шаг 1.1.2
Поднимаем соединение с реляционной базой через SQLAlchemy: собираем строку вида postgresql+psycopg2://user:pass@host:5432/dbname, создаём engine = create_engine(dsn, pool_pre_ping=True) и держим его в одной переменной на весь ноутбук. Сразу ограничиваем выборку на этапе разведки: select * from <таблица> limit 100, чтобы не тянуть миллион строк в память ради пяти первых. Пароль не печатаем в ячейке и не оставляем в выводе — выносим в переменные окружения или в отдельный файл .env, который не попадает в отчёт.
Источник в задании специалистов — не один файл, а связка, и база обычно хранит справочники и транзакционные записи, то есть самые «дорогие» признаки. Аккуратное соединение с pool_pre_ping спасает от обрыва сессии на длинных выгрузках, а чтение через SQLAlchemy даёт корректные типы на выходе и не требует ручного приведения столбцов дат и денег.
Признак успеха простой: pd.read_sql('select * from <таблица> limit 5', engine) возвращает DataFrame с осмысленными именами столбцов и без object-типов там, где заведомо числа или даты. Отдельно проверьте select count(*) — число строк должно совпадать с тем, что вы увидите после полной выгрузки.
Частая ошибка — тянуть таблицу целиком без where и без индексов: запрос висит минуты, а таймаут соединения обрывает его на середине. Вторая — зашить пароль прямо в ячейку и потом показать ноутбук в презентации: это нарушение регламента, за которое работу могут не оценивать.
Эксперт смотрит, есть ли отдельный конфиг подключения и осмысленные имена переменных, а не строка длиной в экран, вклеенная в код. Отдельно смотрит, не осталось ли пароля в выводе ячейки.
Шаг 1.1.3
Разбираем файловые и веб-источники. Для csv-выгрузки задаём разделитель и кодировку явно: pd.read_csv(path, sep=';', encoding='utf-8', decimal=',') — в конкурсных наборах запятая как десятичный разделитель и cp1251 встречаются регулярно. Для json смотрим структуру: pd.json_normalize(data, record_path='items') разворачивает вложенность вместо словаря в одной колонке. Для веб-ресурса берём requests.get с таймаутом 10 секунд и проверкой r.status_code == 200, и сохраняем сырой ответ в файл до разбора.
Критерий «Из заданных источников извлечены данные и сформирован набор информации» стоит 5 баллов — самый весомый в начале модуля, и он проверяется по факту наличия всех источников в итоговом наборе. Явные параметры чтения нужны не для красоты: при ошибочном разделителе весь csv приедет одной колонкой, а при неверной кодировке кириллица превратится в набор символов, и восстановить её без перечитывания файла нельзя.
Проверьте по каждому файлу три вещи: число строк и столбцов совпадает с ожидаемым по описанию источника, первые пять строк читаются человечески (без ромбиков вместо кириллицы), числовые поля имеют тип float или int, а не object. Сырые ответы сохранены в папку raw и открываются повторно.
Типичная ошибка — прочитать csv с разделителем по умолчанию и получить одну колонку, а потом «чинить» это регулярками. Вторая — оставить json вложенным и потерять половину признаков, потому что внутрь словаря аналитика не заглянула.
Эксперт проверяет, что в ноутбуке видно происхождение каждого столбца: путь к файлу или имя таблицы указаны рядом с кодом чтения. Про каждый столбец он готов спросить, откуда тот взялся.
Действие 1.2. Извлечь данные и сформировать единый датафрейм
Шаг 1.2.1
Выгружаем основную таблицу целиком в DataFrame и сразу фиксируем её паспорт: df.shape, df.dtypes, df.head(10). Дальше смотрим кодом: сколько уникальных значений в ключевом поле (df['id'].nunique() против len(df)), нет ли полностью пустых столбцов, нет ли строк-дублей по ключу. Результат каждого замера печатаем в отдельной ячейке, чтобы он остался в истории ноутбука.
Датафрейм — это ещё не набор данных, а черновик: пока не проверены ключи и дубли, любой join может размножить строки, и вы получите выборку в два раза больше исходной, не заметив этого. Критерий «Извлечены данные и сформирован набор данных информации» (5 баллов) эксперт подтверждает по описанию структуры и по совпадению объёмов с источником.
Число строк в DataFrame должно совпадать с count(*) по таблице, уникальность ключа — давать True при проверке df.duplicated(subset='id').any() == False, а полностью пустых столбцов не должно быть вовсе. Если дубли есть, фиксируем их количество и причину до объединения.
Ошибка — сразу строить merge, не проверив уникальность ключа: строки размножаются, средние значения «плывут», и на защите невозможно объяснить, почему в выборке 118 тысяч записей вместо 96. Вторая — оставить в наборе технические столбцы вроде служебного id загрузки и потом удивляться, что модель нашла в них закономерность.
Эксперт смотрит на первые ячейки ноутбука: есть ли явные проверки размерности и ключей, или участник сразу перешёл к describe. Если проверок нет, он считает, что набор не контролировали.
Шаг 1.2.2
Сверяем источники между собой по ключам до объединения. Для каждого вспомогательного источника печатаем его размер, набор ключей и пересечение с основным: len(set(a.id) & set(b.id)) и долю строк основной таблицы, для которых пара нашлась. Если справочник покрывает не всю основную таблицу, решаем заранее, что делать с unmatched-строками, и записываем это решение — how='left' оставляет их с пропусками, how='inner' молча вырезает часть выборки.
Выбор типа соединения — не техническая мелочь, а содержательное решение: inner join по справочнику, который покрывает 70 процентов записей, выбросит треть данных и сместит выборку в сторону крупных клиентов, у которых справочные записи заполнены. Именно на этом шаге появляется большинство будущих пропусков, за которые в модуле А предусмотрены отдельные критерии на 2 и 3 балла.
Перед объединением у вас на руках три числа: размер основного набора, доля совпавших ключей по каждому справочнику и количество строк, которые останутся без соответствия. После объединения размер результирующего набора должен быть равен размеру основного, если справочные ключи уникальны.
Ошибка — соединить по полю с разным форматом (число против строки, пробелы в конце), получить ноль совпадений и не заметить этого, потому что merge не падает, а просто возвращает пропуски. Вторая — сделать inner join «чтобы данные были чище» и потерять четверть выборки без единого слова в отчёте.
Эксперт ищет в ноутбуке явное сравнение объёмов до и после merge; если его нет, считает, что участник не контролировал соединение. Ответ про тип соединения он сопоставляет с числом строк.
Шаг 1.2.3
Собираем итоговый датафрейм: последовательно присоединяем справочники через merge с validate='many_to_one' — pandas сам упадёт, если ключ в правой таблице не уникален. После каждого шага печатаем shape и проверяем, что прирост только по столбцам. Даём столбцам единые имена в snake_case, убираем пробелы и кириллицу из заголовков (df.columns = [c.strip().lower().replace(' ', '_') for c in df.columns]), потому что дальше эти имена пойдут в конвейер и в отчёт.
Параметр validate — самый дешёвый способ поймать размножение строк: он превращает тихую ошибку в понятное исключение прямо в момент объединения. Единые имена столбцов нужны, чтобы конвейер в модуле А и модели в модуле С работали с одним и тем же набором признаков, а не с тремя вариантами написания одного поля.
Проверьте три признака: shape после последнего merge совпадает с ожидаемым числом строк, список столбцов не содержит пар вида name_x и name_y, а df.columns полностью в нижнем регистре без пробелов. Дубли по ключу отсутствуют: df.duplicated(subset='id').sum() == 0.
Частая ошибка — оставить суффиксы _x и _y после merge и потом обращаться к name_x, не понимая, откуда он взялся. Вторая — переименовать столбцы «для красоты» после того, как часть кода уже написана, и получить KeyError в середине модуля.
Эксперт смотрит на итоговую таблицу признаков в отчёте и сверяет имена столбцов в коде и в описании: расхождение читается как небрежность. Суффиксы _x и _y в столбцах он читает как признак спешки.
Действие 1.3. Описать структуру набора данных
Шаг 1.3.1
Составляем паспорт признаков таблицей в отчёте: для каждого столбца указываем смысл, единицу измерения, тип, диапазон и роль в задаче — признак, идентификатор, целевая переменная или технический столбец. Идентификаторы помечаем отдельно, потому что в модель они не идут. Для целевой переменной обязательно пишем, как она получена и на каком периоде измерена, иначе в модуле С невозможно доказать, что модель не видит будущее.
Критерий «Описана структура набора данных» у специалистов стоит 1 балл, но он открывает дорогу к более дорогим пунктам: без понимания, что означает каждый столбец, невозможно обосновать выбор метода заполнения пропусков (3 балла) и метод кодирования категориальных признаков (5 баллов). Эксперт читает паспорт признаков первым, ещё до кода.
В паспорте нет пустых строк: у каждого из столбцов заполнены смысл, тип и единица. Число строк таблицы равно числу столбцов в датафрейме — проверьте это программно, len(df.columns), иначе половина признаков останется неописанной.
Ошибка — написать «признак 3 — числовой» вместо смысла: такой паспорт не отвечает на вопрос, почему для него выбрана медиана, а не мода. Вторая — забыть про целевую переменную и её происхождение, из-за чего на защите нечем объяснить метрики модуля С.
Эксперт сверяет паспорт с реальными столбцами и спрашивает про два-три признака наугад: если участник не может объяснить единицы, балл за описание не ставится.
Шаг 1.3.2
Фиксируем структуру в самом ноутбуке: отдельная ячейка с df.info(), df.shape и df.head(), отдельная — с распределением типов (df.dtypes.value_counts()), отдельная — с перечнем пропусков по столбцам в процентах (df.isna().mean().mul(100).sort_values()). Рядом текстовой ячейкой пишем вывод в три-четыре предложения: сколько записей, сколько признаков, какие источники соединены, где пропуски.
Такой блок экономит время в модуле В: к нему возвращаются, когда нужно объяснить, почему в корреляционной матрице не хватает столбца или почему признак с 60 процентами пропусков вообще остался в наборе. Кроме того, текстовая ячейка с выводом — это заготовка раздела отчёта, за который в модуле В дают 5 баллов.
Блок воспроизводится сверху вниз без ошибок, все три вывода напечатаны и сохранены в файле ноутбука. Число строк в info() совпадает с числом, указанным в текстовой ячейке, — расхождение означает, что ноутбук запускали не по порядку.
Ошибка — перезапустить ноутбук и не сохранить выводы: в отчёте потом висят цифры от старой версии данных. Вторая — оставить выводы только в голове, а в отчёт перенести их по памяти уже после модуля С, когда цифры забыты.
Эксперт открывает ноутбук и проверяет, что порядок ячеек совпадает с порядком выполнения: счётчик In[] должен идти по возрастанию. При сбитых счётчиках In[] он просит перезапустить ноутбук.
Задача 2. Очистить данные: пропуски, типы, масштабы, категориальные признакиМодуль А · до 20 баллов
Вторая половина модуля А — самая баллоёмкая: пропуски с обоснованием метода дают 5 баллов, исправление типов 5, масштабирование количественных признаков 5, переход от категориальных к числовым 5 — итого 20 баллов, а сохранение датафрейма и конвейер вынесены в следующую задачу. Здесь важно не просто «почистить», а показать решение и его причину: за вывод о наличии пропусков и обоснование метода эксперты ставят отдельные оценочные баллы, которые нельзя добрать кодом.
Действие 2.1. Разобраться с пропущенными значениями
Шаг 2.1.1
Считаем пропуски по каждому столбцу в абсолютных числах и в процентах, а затем смотрим не только сколько, но и где: df.isna().mean().sort_values(ascending=False) даёт общую картину, а df.groupby(df['Признак'].isna())['Целевая'].describe() показывает, связан ли факт пропуска с целевой переменной. Строим матрицу пропусков (msno.matrix или heatmap из df.isna()) — на ней видно, разбросаны пропуски или идут блоками.
Критерий «Сделан вывод о наличии пропущенных значений в наборе данных» стоит 2 балла, а следующий за ним — «Обоснован выбор метода решения проблемы пропущенных значений» — ещё 3 оценочных балла. Обосновать метод можно только после того, как вы посмотрели на структуру пропусков: если пропуски идут блоком за конкретный месяц, медиана всего столбца их исказит.
У вас должен быть список столбцов с указанием доли пропусков и вывод по каждому: случайные, связанные с другим признаком или системные. Дополнительно проверьте, нет ли строк, где пусто больше половины столбцов, — df.isna().sum(axis=1) даёт их точное число.
Ошибка — ограничиться одной строкой df.isnull().sum() и на этом закончить разведку: потом невозможно объяснить, почему для столбца с 40 процентами пропусков выбрана медиана, а не удаление. Вторая — не заметить пропуски, закодированные строкой «нет данных» или нулём: isna() их не видит, а модель считает нулём.
Эксперт просит показать матрицу или таблицу пропусков и слушает, как участник объясняет их природу: это оценочный критерий, код здесь вторичен. По матрице видно, пропуски блочные или разбросаны случайно.
Шаг 2.1.2
Выбираем метод по типу признака и доле пропусков и записываем решение в отчёт словами. Для числовых признаков с нормальным распределением — среднее, с асимметрией и выбросами — медиана, для категориальных — мода или отдельный уровень «неизвестно», для признаков с долей пропусков выше 50–60 процентов — удаление столбца, для строк с пустой целевой переменной — удаление, обучать на них нечем. Если пропуск неслучаен, добавляем бинарный индикатор пропуска: сам факт отсутствия значения бывает сильным признаком.
За этот выбор дают 3 оценочных балла, и они ставятся только при наличии аргумента: «медиана устойчива к выбросам, а в столбце стоимости 4 процента значений выше 99-го процентиля» — это обоснование, «заполнил медианой, потому что так принято» — нет. Индикатор пропуска часто добавляет к качеству модели больше, чем сам выбор заполнения, и это тоже аргумент.
Решение записано по каждому столбцу, а не одной фразой на весь набор. Для каждого метода указана причина и ожидаемый эффект: сколько строк или столбцов исчезнет, изменится ли среднее. После заполнения df.isna().sum().sum() должно быть равно нулю — либо осознанно оставлены столбцы, которые вы решили не трогать.
Ошибка — заполнить всё средним, включая категориальные признаки и целевую переменную: в целевой это создаёт фиктивные ответы, на которых модель учится предсказывать саму медиану. Вторая — удалить все строки с любым пропуском, потеряв половину выборки и сместив её состав.
Эксперт вызывает участника к экрану и просит объяснить два решения наугад; если аргумент не воспроизводится, оценочные баллы снимаются. Если аргумент общий, он просит назвать столбец и его распределение.
Шаг 2.1.3
Реализуем заполнение внутри конвейера, а не «в лоб» по всему датафрейму: SimpleImputer(strategy='median') для числовых столбцов, SimpleImputer(strategy='most_frequent') или константа 'unknown' для категориальных, add_indicator=True там, где решили добавить индикатор. Перед этим отдельно обрабатываем целевую переменную: строки с пустой целью вырезаем до всякого fit. Все решения фиксируем в одном ColumnTransformer, чтобы они применялись одинаково к train и к новым данным.
Главная причина держать заполнение в конвейере — утечка данных: если медиану посчитать по всему набору, включая валидацию, модель формально обучается на информации из отложенной части и метрики в модуле С становятся завышенными. Критерий «Решена проблема пропущенных значений» даёт 3 балла измеримых, и проверяют его именно по отсутствию пустых ячеек в подготовленном датафрейме.
После преобразования проверьте три вещи: в выходном массиве нет NaN (numpy.isnan(X).sum() == 0 при числовом типе), число строк не уменьшилось без вашего решения, а индикаторные столбцы появились только там, где задумано. Сравните среднее и медиану столбца до и после заполнения — сдвиг не должен быть катастрофическим.
Ошибка — посчитать медиану по всему набору, а потом удивляться, что качество на валидации в модуле С падает при переходе к реальным данным. Вторая — заполнить пропуски до разделения на train и valid и не отметить этого в отчёте: на защите это первый вопрос эксперта.
Эксперт смотрит, вызывается ли imputer.fit только на обучающей части и нет ли в ноутбуке отдельной строки с заполнением по всему df. Отдельно проверяет, нет ли заполнения по всему df до разделения.
Действие 2.2. Определить типы данных и исправить несоответствия
Шаг 2.2.1
Проходим по столбцам и сверяем фактический тип с ожидаемым по смыслу. Ищем три типовые аномалии: числа, приехавшие строками (потому что в столбце встретилась запятая, пробел-разделитель тысяч или прочерк), даты в виде строк в разных форматах (2024-03-01 и 01.03.2024 в одном столбце) и категориальные поля, где одни и те же значения написаны по-разному, включая регистр и лишние пробелы. Проверяем диапазоны: отрицательный возраст и год рождения 1899 — тоже несоответствие типа и смысла.
Критерий «Определены типы данных признаков, сделаны выводы о соответствии» стоит 2 балла, а «Исправлены несоответствующие типы» — ещё 3. Формально object-столбец с числами ломает масштабирование и корреляционный анализ: модуль В просто не построит матрицу, а в модуле С конвейер упадёт на этапе fit.
Составлен список столбцов с несоответствием и указано, каким тип должен быть. После приведения df.dtypes не содержит object там, где по смыслу числа или даты, а describe() по числовым столбцам выдаёт осмысленные min и max, а не счётчик строк.
Ошибка — применить astype(float) к столбцу с запятыми и получить исключение, а затем «решить» проблему удалением столбца. Вторая — привести дату к datetime без указания формата, когда в данных смешаны два формата: часть значений станет NaT, и это заметят только в модуле В.
Эксперт смотрит на таблицу до и после приведения типов: важна не только правильность, но и то, что участник её зафиксировал. Найденные несоответствия он сверяет с паспортом признаков.
Шаг 2.2.2
Приводим типы осознанно и с проверкой результата. Для чисел: df['col'] = pd.to_numeric(df['col'].str.replace(' ', '').str.replace(',', '.'), errors='coerce') — coerce превращает нераспознанное в NaN, и эти пропуски надо сразу посчитать. Для дат: pd.to_datetime(df['col'], format='%Y-%m-%d', errors='coerce'), при смешанных форматах сначала разбираем строку, потом приводим. Категориальные поля переводим в тип category с явным списком уровней, а строки чистим от пробелов и приводим регистр.
Преобразование с errors='coerce' без последующего подсчёта — скрытая потеря данных: десять записей с прочерком молча становятся NaN, и к разговору о пропусках вы уже не вернётесь. Явный формат даты нужен, чтобы не получить американский порядок месяца и дня там, где в источнике европейский, — такая ошибка меняет смысл признака целиком, а не отдельные значения.
После каждого приведения печатайте число новых NaN и сравнивайте с ожидаемым: если их стало больше, чем было прочерков, разбор строки неполный. Проверьте диапазоны: возраст в пределах 0–100, суммы не отрицательные (или отрицательные только там, где это возвраты), даты не уходят в будущее.
Ошибка — использовать errors='ignore' и не заметить, что столбец так и остался строковым. Вторая — приводить дату без формата и получать перепутанные день и месяц в половине строк: внешне данные выглядят нормально, а сезонность в анализе «съезжает».
Эксперт проверяет, что после приведения в ноутбуке есть повторный dtypes и он не совпадает с исходным — это доказательство работы. Если dtypes не изменились, работа по этому пункту не засчитывается.
Действие 2.3. Определить шкалы и масштабировать количественные признаки
Шаг 2.3.1
Для каждого числового признака определяем шкалу: минимум, максимум, квартили, медиану и наличие выбросов по правилу 1,5 межквартильного размаха. Печатаем df[num_cols].describe(percentiles=[.01, .25, .5, .75, .99]) и для каждого столбца отмечаем, во сколько раз максимум отличается от медианы. Признаки с разбросом в сотни раз (выручка и количество визитов в одном наборе) — прямые кандидаты на масштабирование, а признаки с тяжёлым хвостом — на логарифмирование до него.
Критерий «Для количественных признаков определены шкалы изменения, проведено масштабирование» стоит 5 баллов — один из самых дорогих в модуле А. Без оценённых шкал невозможно ни выбрать scaler, ни объяснить, почему модель на одних признаках «слышит» только выручку: алгоритмы на расстояниях и градиентный спуск чувствительны к масштабу.
В отчёте есть таблица шкал: для каждого числового столбца минимум, максимум, медиана, квартили и решение — масштабировать, логарифмировать или оставить как есть. Решение по каждому столбцу подкреплено числом, а не общим впечатлением.
Ошибка — масштабировать всё подряд, включая бинарные индикаторы и целевые переменные: смысл теряется, а интерпретация коэффициентов усложняется. Вторая — не заметить выброс в 300 медиан и после StandardScaler получить столбец, где 99 процентов значений лежат в диапазоне от -0,1 до 0,1.
Эксперт просит показать распределение одного признака с выбросами и слушает, что участник собирается с ним делать. Он просит назвать число выбросов, а не показать график.
Шаг 2.3.2
Выбираем способ масштабирования по форме распределения и по типу модели. StandardScaler — когда распределение близко к нормальному и модель линейная или на градиентном спуске; RobustScaler — когда есть заметные выбросы, он считает по медиане и межквартильному размаху; MinMaxScaler — когда нужен строгий диапазон от нуля до единицы, например для нейросети; логарифм или корень — когда признак имеет степенное распределение и выбросы не ошибки, а реальные крупные значения.
Выбор scaler — это отдельное решение с обоснованием, и оно входит в те же 5 баллов: эксперт смотрит, понимает ли участник разницу между устойчивым и неустойчивым масштабированием. Для деревьев решений масштаб не важен, и это тоже допустимое обоснование — но тогда его надо написать явно, а не молча пропустить шаг.
Решение по каждому признаку записано: тип scaler, причина, ожидаемый результат. Если признак логарифмируется, в отчёте указано, что после обратного преобразования прогноз надо вернуть в исходные единицы, — иначе метрики в модуле С будут считаться в логарифмах.
Ошибка — применить StandardScaler к признаку с выбросами и получить столбец, в котором вся полезная вариация сжата в ноль. Вторая — масштабировать целевую переменную и забыть об этом, а потом докладывать RMSE в безразмерных единицах.
Эксперт спрашивает, почему выбран именно этот scaler, и проверяет, что ответ не сводится к «так удобнее». Выбор он сверяет со шкалой, посчитанной и записанной в отчёте.
Шаг 2.3.3
Реализуем масштабирование в конвейере: StandardScaler или RobustScaler ставим в Pipeline после импутера, чтобы параметры считались на обучающей части и применялись к валидации без пересчёта. Для логарифмирования используем FunctionTransformer(np.log1p, inverse_func=np.expm1) — она сохраняет обратимость и не падает на нулях. После fit проверяем: среднее близко к нулю, отклонение — к единице.
Масштабирование, посчитанное по всему набору, — такая же утечка, как и заполнение пропусков по всему набору: среднее и разброс валидации попадают в обучающую статистику. Критерий проверяется по факту наличия преобразования и по его корректному месту в конвейере, поэтому порядок шагов здесь принципиален.
Проверьте численно: df_scaled[col].mean() в пределах ±0,01, std в пределах 0,99–1,01 для StandardScaler; для RobustScaler — медиана около нуля. Форма массива не изменилась, имена столбцов сохранились, а типы остались числовыми.
Ошибка — вызвать fit_transform на объединённом наборе, а потом разделить его на train и valid: метрики выглядят лучше реальности. Вторая — масштабировать после разделения, но каждый набор отдельно, из-за чего преобразования train и valid несовместимы.
Эксперт смотрит на порядок операций в конвейере: imputer, затем scaler, и ни одного fit вне train. Fit вне обучающей части он трактует как утечку и снимает балл.
Действие 2.4. Перевести категориальные признаки в числовые
Шаг 2.4.1
Для каждого нечислового признака считаем количество уникальных значений и их частоты: df[col].nunique() и df[col].value_counts(normalize=True).head(15). Смотрим, сколько уровней встречается реже одного процента, — такие редкие значения почти всегда шум, и их либо объединяют в группу «прочее», либо оставляют на усмотрение кодировщика. Отдельно проверяем почти-дубли: «Москва», «москва» и «г. Москва» — один уровень, склеивать их надо до кодирования.
Критерий «Для категориальных признаков определено количество уникальных значений, выбран и реализован метод перехода к числовым значениям» стоит 5 баллов. Кардинальность — главный аргумент при выборе метода: одно дело 8 регионов, другое — 4000 артикулов, где one-hot даст матрицу, в которой модель утонет.
В отчёте есть таблица: признак, число уникальных значений, доля топ-5 уровней, выбранный метод кодирования и причина. После нормализации почти-дублей число уровней уменьшилось — это зафиксировано до и после.
Ошибка — кодировать признак с 3000 уникальных значений через get_dummies и получить матрицу в сотни тысяч столбцов, на которой обучение не успевает за время модуля С. Вторая — не заметить, что признак на самом деле числовой и просто записан текстом.
Эксперт смотрит на таблицу кардинальности: наличие цифр по каждому признаку — обязательное условие балла. Число столбцов после кодирования он сверяет с таблицей уровней.
Шаг 2.4.2
Выбираем метод кодирования по кардинальности и по смыслу признака. Для номинальных с числом уровней до 10–15 — OneHotEncoder с handle_unknown='ignore' и drop='first' для линейных моделей; для порядковых (уровень образования, категория риска) — OrdinalEncoder с явно заданным порядком, потому что порядок несёт информацию; для высокой кардинальности — частотное кодирование (замена уровня его долей) или target encoding внутри кросс-валидации; при тысячах уровней допустим HashingEncoder.
Обоснование метода — часть тех же 5 баллов, и на защите его спрашивают первым: one-hot на 4000 уровнях создаёт разреженную матрицу и повышает риск переобучения, ординальное кодирование номинального признака навязывает ложный порядок, а частотное кодирование сохраняет информацию о популярности уровня без разрастания размерности.
Решение записано по каждому признаку: метод, число столбцов после кодирования, причина. Для порядковых указан явный список уровней в нужном порядке — его можно распечатать и показать. Для номинальных проверено, что модель не получит ложной иерархии.
Ошибка — применить OrdinalEncoder к номинальному признаку вроде города: модель решит, что «Уфа» больше «Октябрьского», и найдёт несуществующую закономерность. Вторая — кодировать категории вручную через map со словарём, который не покрывает все значения, и получить NaN там, где их не было.
Эксперт спрашивает про порядковый признак и про признак с высокой кардинальностью: именно на них видно, думал участник или применял первый попавшийся кодировщик.
Шаг 2.4.3
Реализуем кодирование в ColumnTransformer: OneHotEncoder(handle_unknown='ignore', drop='first', sparse_output=False) для номинальных, OrdinalEncoder с categories=[уровни] для порядковых, а частотное — через замену уровня его долей, посчитанной на train. После fit проверяем: число столбцов на выходе равно ожидаемому (число уровней минус один для каждого one-hot признака), имена выходных столбцов читаемы, а новые категории в валидации не вызывают ошибки.
handle_unknown='ignore' — страховка на реальных данных: в валидации или в финальном прогоне почти всегда появляется уровень, которого не было в train, и без этого параметра конвейер падает с исключением прямо на защите. drop='first' убирает линейную зависимость между столбцами, из-за которой коэффициенты линейной модели становятся неинтерпретируемыми.
Проверьте обратное преобразование там, где оно поддерживается, и сверьте несколько строк глазами: у одной записи должен быть ровно один активный столбец на каждый one-hot признак. Число столбцов совпадает с расчётом, а доля единиц в разреженной матрице не превышает 5–10 процентов.
Ошибка — обучать кодировщик на объединённых данных и получать утечку через категории, которых в train не было. Вторая — забыть drop='first' и потом полчаса объяснять, почему коэффициенты линейной регрессии поменяли знак.
Эксперт проверяет, что кодирование живёт в конвейере и что для него указаны параметры, а не оставлены значения по умолчанию без комментария. Он смотрит, задан ли явный порядок уровней у порядковых признаков.
Задача 3. Сохранить подготовленный датафрейм и собрать конвейер обработкиМодуль А · до 7 баллов
Модуль А заканчивается двумя артефактами, которые проверяют отдельно: сохранённым датафреймом в требуемом формате (2 балла) и конвейером обработки данных, содержащим все выполненные шаги (5 баллов). Конвейер — это не формальность: именно он гарантирует, что модель в модуле С увидит данные в том же виде, в каком вы их готовили, и что новые записи пройдут те же преобразования без ручных правок.
Действие 3.1. Сохранить предобработанный датафрейм
Шаг 3.1.1
Сохраняем результат в папку с номером участника, имя файла строим по шаблону из задания — например prepared_[номер].parquet или dataset_[номер].csv. Parquet предпочтительнее: он сохраняет типы столбцов, включая даты и категории. Сохраняем с index=False, а кодировку для csv указываем явно, utf-8-sig, чтобы кириллица открывалась и в Excel. Отдельно сохраняем словарь признаков в json — он понадобится для отчёта и для проверки схемы на входе модели.
Критерий «Предобработанные данные сохранены в требуемом формате датафрейма» стоит 2 балла, и он бинарный: либо файл есть и читается, либо балла нет. Тип файла важен содержательно — при сохранении в csv теряются категориальные типы и даты, и модуль С получит столбцы object, которые придётся приводить заново.
Файл существует по ожидаемому пути, размер больше нуля, а чтение обратно даёт ту же форму: pd.read_parquet(path).shape совпадает с df.shape. Кодировка csv проверяется открытием файла в блокноте или вторым читателем с encoding='utf-8'.
Ошибка — сохранить с индексом и потом получить лишний столбец Unnamed: 0, который попадёт в признаки. Вторая — записать файл в домашнюю папку вместо папки участника: эксперт ищет артефакт по регламентированному пути и не находит его.
Эксперт проверяет наличие файла и его читаемость в момент оценки модуля, не откладывая на конец конкурса. Файл он открывает сам, не полагаясь на путь из вашей ячейки.
Шаг 3.1.2
Проверяем сохранение обратным чтением: читаем файл заново, сравниваем shape, список столбцов и типы, печатаем первые пять строк и количество пропусков. Если формат csv — отдельно контролируем, что десятичный разделитель и кодировка не испортили числа: после чтения столбец должен быть float, а не object. Для parquet дополнительно сверяем, что категориальные столбцы вернулись категориями, а даты — датами.
Проверка обратным чтением закрывает самый обидный сценарий: файл сохранён, но при чтении pandas подставил другой разделитель, и все числовые признаки приехали текстом. Эксперт оценивает не факт записи, а пригодность файла к дальнейшей работе, и на этом расхождении теряются те самые 2 балла.
Сравнение печатается попарно: исходное и прочитанное значения shape, число столбцов, типы. Расхождений быть не должно; если появились, причина в параметрах записи или чтения, а не в данных. После чтения типы сверяются с исходными.
Ошибка — считать проверку лишней и обнаружить проблему только в модуле С, когда до сдачи остаётся двадцать минут. Вторая — перезаписать исходный сырой файл тем же именем и потерять возможность пересобрать набор.
Эксперт может попросить открыть сохранённый файл при участнике: готовность это сделать — тоже сигнал качества. Если файл читается только в вашем ноутбуке, это минус.
Действие 3.2. Собрать конвейер обработки данных
Шаг 3.2.1
Собираем ColumnTransformer, в котором каждому блоку столбцов соответствует своя цепочка: числовые — Pipeline из импутера и масштабирования, категориальные — Pipeline из импутера с константой и OneHotEncoder или OrdinalEncoder. Сверху надеваем общий Pipeline, куда при необходимости добавляем шаг отбора признаков и саму модель. Всё решение по каждому блоку должно совпадать с тем, что вы обосновали в предыдущих действиях, — конвейер это просто форма записи ваших решений.
Критерий «Создан конвейер данных (data pipeline), содержащий все шаги обработки данных» стоит 5 баллов у специалистов. Проверяют не наличие объекта, а полноту: импутация, масштабирование, кодирование и отбор должны быть внутри, а не остаться в отдельных ячейках ноутбука, которые придётся повторять вручную.
Печатаем print(prep) и проверяем, что в выводе перечислены все блоки и все шаги. Количество столбцов на выходе prep.fit_transform(X_train).shape[1] совпадает с вашим расчётом по числу уровней и числу числовых признаков.
Ошибка — собрать конвейер только для числовых признаков, а категориальные обработать отдельно вне его: на новых данных такой конвейер не воспроизводит подготовку. Вторая — оставить в конвейере шаг, который на самом деле не применялся при исследовании, и получить другой набор признаков.
Эксперт открывает объект конвейера и смотрит состав шагов, сверяя его с решениями из отчёта. Шаги конвейера он сверяет с таблицей решений в самом отчёте.
Шаг 3.2.2
Прогоняем конвейер на сырых данных, как на настоящих: берём необработанный кусок файла, пропускаем через fit_transform на обучающей части и transform на валидационной, и только потом смотрим результат. Проверяем устойчивость к неизвестным категориям и к новым пропускам — специально подсовываем строку с уровнем, которого не было в train, и убеждаемся, что transform не падает. Это занимает минуту и снимает половину рисков модуля С.
Тест на неизвестных данных — лучший способ доказать, что конвейер рабочий, а не декоративный: в реальной эксплуатации новые категории появляются всегда, и падение на них означает, что решение непригодно. Кроме того, этот прогон выявляет утечку: если результат transform на валидации зависит от данных валидации, значит вы где-то случайно вызвали fit_transform на всём наборе.
Валидационный прогон завершается без исключений, размер выходной матрицы совпадает по числу строк с входным, а в столбцах нет NaN. Строка с новой категорией дала нули в соответствующем блоке one-hot столбцов, а не ошибку.
Ошибка — проверять конвейер только на тех же данных, на которых он обучался: тогда любая проблема с новыми категориями и типами останется незамеченной. Вторая — забыть, что после fit_transform порядок столбцов фиксирован, и потом сопоставлять признаки по позиции.
Эксперт просит показать запуск на новой строке: это самый быстрый способ отличить настоящий конвейер от набора отдельных функций. Падение на неизвестной категории он считает дефектом решения.
Шаг 3.2.3
Фиксируем окружение и параметры воспроизводимости: сохраняем список версий библиотек (pip freeze > requirements.txt), задаём random_state=42 во всех стохастических объектах, включая разделение выборки, леса и градиентный бустинг. Записываем в отчёт, какая версия данных использована и какие шаги в каком порядке идут, — короткой таблицей из четырёх-пяти строк.
Воспроизводимость — не абстрактное требование: на защите эксперты могут попросить повторить прогон, и расхождение метрик на десятые доли без объяснения читается как нестабильное решение. Фиксированный random_state делает сравнение двух моделей честным: разница в качестве тогда объясняется моделью, а не случайным разбиением.
Повторный запуск ноутбука сверху вниз даёт те же числа метрик с точностью до третьего знака. Версии библиотек сохранены в файле, а random_state присутствует в каждом конструкторе, где он предусмотрен, — это видно поиском по коду.
Ошибка — оставить random_state=None и потом не суметь объяснить, почему вчерашняя модель давала 0,81, а сегодня 0,78. Вторая — перезапускать ноутбук выборочно и получать состояние, которое невозможно воспроизвести на защите.
Эксперт смотрит, воспроизводится ли прогон: это отдельный сигнал инженерной зрелости участника. Он просит назвать версии библиотек и значение seed в отчёте.
Задача 4. Провести анализ, визуализировать данные и отобрать признакиМодуль В · 35 баллов
Модуль В длится 1 час 40 минут и даёт 35 баллов: распределения, описательные статистики, корреляции, ответы на частные вопросы работодателя, отбор признаков и отчёт. Здесь важно помнить, что оценивают не только расчёты, но и качество графиков (3 балла) и качество оформления отчёта (3 оценочных балла), а каждый рисунок должен отвечать на конкретный вопрос, поставленный в задании.
Действие 4.1. Исследовать распределения признаков
Шаг 4.1.1
Строим гистограммы с ядром плотности для всех количественных признаков: fig, axes = plt.subplots(3, 3, figsize=(15, 12)), в каждой ячейке ax.hist(df[col].dropna(), bins=30, density=True) и поверх sns.kdeplot. Подписываем оси с единицами и заголовок. Для признаков с тяжёлым правым хвостом строим второй ряд в логарифмической шкале, чтобы форма стала читаемой, и сохраняем рисунки в папку figures с осмысленными именами вида hist_cost.png.
Критерий «Исследовано распределение значений признаков» стоит 5 баллов, и эксперт смотрит на два признака: есть ли графики по всем количественным столбцам и сделаны ли из них выводы. Логарифмическая шкала нужна потому, что на обычной гистограмме выручка с одним гигантским значением выглядит как один столбик у нуля, и никакой информации о форме распределения не даёт.
По каждому признаку сформулирован вывод в одно предложение: симметричное, с правой асимметрией, бимодальное или с выбросами. Число графиков равно числу количественных признаков, у каждого подписаны оси и единицы, а файлы сохранены.
Ошибка — нарисовать одну общую гистограмму по всему датафрейму и считать пункт закрытым: разные шкалы делают такой график бессмысленным. Вторая — оставить графики без подписей осей, за что снимаются баллы за качество диаграмм.
Эксперт подходит во время модуля и смотрит на набор графиков в папке figures: их количество и подписи. Он проверяет, есть ли график по каждому количественному признаку.
Шаг 4.1.2
Для категориальных признаков строим горизонтальные столбчатые диаграммы частот: value_counts().head(15).plot(kind='barh'), сортировка по убыванию, подпись доли в процентах рядом со столбцом. Если уровней больше пятнадцати, показываем топ-15 и отдельный столбец «остальные» с суммарной долей, чтобы график остался читаемым. Для порядковых признаков сохраняем естественный порядок уровней, а не сортировку по частоте.
На диаграммах частот видно то, чего не видно в таблице: перекос в один уровень и почти пустые категории. Это напрямую влияет на решение о кодировании и на предупреждение о несбалансированности выборки, которое эксперты ждут в отчёте. Кроме того, графики частот входят в те же 5 баллов за исследование распределений.
Для каждого категориального признака есть диаграмма, на ней подписаны доли, а сумма долей топ-15 и «остальных» равна 100 процентам. Уровни с долей меньше 1 процента отмечены — по ним вы приняли решение при кодировании.
Ошибка — строить круговую диаграмму с двадцатью секторами: она нечитаема и экспертом оценивается как некачественная визуализация. Вторая — показывать абсолютные числа без долей, из-за чего невозможно сравнить признаки между собой.
Эксперт оценивает читаемость: подписи, сортировку, отсутствие наложений текста. Он смотрит, подписаны ли у столбцов доли, а не только названия уровней.
Шаг 4.1.3
Отдельно исследуем целевую переменную. Для задачи регрессии строим гистограмму и boxplot, считаем асимметрию и долю значений за пределами трёх стандартных отклонений. Для классификации считаем баланс классов: df['target'].value_counts(normalize=True) и столбчатую диаграмму, а при дисбалансе — распределение признаков по классам, чтобы видеть, разделимы ли они.
Всё, что делается дальше в модуле С, зависит от формы целевой переменной: при сильном дисбалансе accuracy вводит в заблуждение и нужны precision, recall и F1, а при скошенной целевой переменной в регрессии метрика RMSE будет определяться несколькими крупными объектами. Вывод об этом — часть ответа на частные вопросы (5 баллов) и заготовка для обоснования метрик (3 балла).
Записаны три числа: доля каждого класса или квартили целевой переменной, асимметрия, число выбросов по правилу трёх сигм. Вывод сформулирован словами: выборка сбалансирована или нет, нужна ли стратификация при разделении.
Ошибка — пропустить анализ целевой переменной и обнаружить дисбаланс 95 на 5 только после обучения, когда метрики уже посчитаны и выводы написаны. Вторая — удалить выбросы в целевой переменной без обоснования, лишив модель важной части спектра.
Эксперт спрашивает про баланс классов или форму распределения целевой переменной — это вопрос, который задают почти всегда. Он ждёт числа: доли классов или квартили целевой переменной.
Действие 4.2. Вычислить описательные статистики
Шаг 4.2.1
Считаем полный набор описательных характеристик: df.describe().T даёт count, mean, std, min, квартили и max, а сверху добавляем моду (df[col].mode().iloc[0]), медиану, дисперсию (df[col].var()) и асимметрию (df[col].skew()). Для категориальных признаков считаем моду и число уровней. Собираем всё в одну таблицу stats и сохраняем её в csv — она станет таблицей 1 в отчёте.
Критерий «Вычислены описательные статистические характеристики признаков (экстремумы, среднее, мода, медиана, дисперсия)» стоит 5 баллов, и проверяют его по наличию всех перечисленных величин, а не только среднего. Мода и медиана нужны как проверка симметрии: если среднее вдвое больше медианы, распределение скошено вправо, и это меняет выбор и заполнения пропусков, и метрик.
В таблице по каждому признаку заполнены все шесть характеристик, нет пропусков в самой таблице, а значения согласуются со шкалами, определёнными в модуле А. Дисперсия указана в квадратных единицах признака — это стоит проверить при подписи столбца.
Ошибка — ограничиться describe() и не посчитать моду и дисперсию, хотя они прямо перечислены в критерии: теряется часть баллов буквально за отсутствующий столбец. Вторая — посчитать статистики по всему набору, включая технические идентификаторы, и получить бессмысленные средние по номерам записей.
Эксперт открывает таблицу статистик и ищет в ней именно те величины, которые перечислены в критерии. Числа в таблице он сверяет со своим контрольным расчётом.
Шаг 4.2.2
Интерпретируем таблицу, а не просто приводим её. Для каждого количественного признака сравниваем среднее и медиану, смотрим отношение стандартного отклонения к среднему и отмечаем признаки, где разброс превышает само среднее. Формулируем выводы: у каких признаков есть длинный правый хвост, где нулевая медиана при ненулевом среднем, какие признаки стоит логарифмировать перед моделью.
Без интерпретации таблица статистик — просто числа, и оценочные баллы за неё не ставятся. Именно выводы связывают модуль В с модулем С: если вы заметили, что признак распределён экспоненциально, это обоснование и для логарифмирования, и для выбора устойчивой метрики.
Под таблицей есть связный абзац на пять-семь предложений с конкретными числами: сколько признаков скошено, у какого коэффициент вариации выше 100 процентов, какие решения из этого следуют. Абзац можно без правок перенести в отчёт.
Ошибка — написать «данные в целом нормальные» без чисел: такой вывод не проверяем и не принимается. Вторая — интерпретировать признаки, которые в модель не пойдут, и тратить на это время. Вывод без чисел не принимается: его нельзя проверить.
Эксперт читает именно выводы под таблицей: по ним видно, понимает ли участник, что означают посчитанные числа. Он ищет в выводах числа, а не оценки вроде «нормально».
Действие 4.3. Исследовать корреляции и мультиколлинеарность
Шаг 4.3.1
Строим матрицу корреляций по числовым признакам: corr = df[num_cols].corr(method='pearson'), затем тепловую карту sns.heatmap(corr, annot=True, fmt='.2f', cmap='coolwarm', vmin=-1, vmax=1). Если признаков больше двадцати, аннотации отключаем, а вместо них выводим список пар с модулем корреляции выше 0,5. Для признаков с явной нелинейностью и выбросами дополнительно считаем Спирмена и сравниваем: расхождение Пирсона и Спирмена — сигнал нелинейной связи.
Критерий «Исследованы корреляционные зависимости между признаками, сделаны выводы» стоит 5 баллов, а «Построены диаграммы и графики, визуализирующие корреляционные зависимости» — ещё 5. Нужны оба элемента: и матрица, и текстовый вывод о том, какие связи содержательные, а какие — следствие общей природы признаков.
Тепловая карта читается: подписи признаков не перекрываются, шкала цвета подписана, значения в ячейках видны. Под графиком есть вывод о трёх-четырёх самых сильных парах с коэффициентами, названными точно.
Ошибка — построить матрицу по всем столбцам, включая текстовые, и получить ошибку или пустую карту. Вторая — интерпретировать корреляцию 0,15 как «сильную связь», что на защите сразу показывает отсутствие статистической грамотности.
Эксперт проверяет, различает ли участник статистическую и содержательную значимость связи. Он спрашивает, какие связи содержательные, а какие ложные и почему.
Шаг 4.3.2
Ищем мультиколлинеарность: выделяем пары с модулем корреляции выше 0,8 и для линейных моделей считаем коэффициент инфляции дисперсии через statsmodels: from statsmodels.stats.outliers_influence import variance_inflation_factor. Значения выше 10 означают, что признак почти полностью объясняется остальными, и в линейную модель его лучше не включать или объединить с парным. Решение по каждой такой паре фиксируем письменно с указанием, какой признак оставлен и почему.
Мультиколлинеарность не мешает деревьям, но ломает интерпретацию коэффициентов линейной модели и делает её неустойчивой: при небольшом изменении выборки знаки коэффициентов меняются. Для специалистов это особенно важно, потому что в модуле С нужно обосновать выбор модели, а не просто получить число метрики.
Список пар с r выше 0,8 составлен и по каждой принято решение. Для линейной модели VIF всех оставленных признаков ниже 10, и это проверено кодом, а не на глаз. Значения VIF сверяются с общепринятым порогом 10.
Ошибка — оставить оба признака-близнеца в линейной модели, получить нестабильные коэффициенты и не суметь объяснить, почему вес одного отрицательный. Вторая — удалять признаки механически, не проверив, не является ли один из них целевым в другой формулировке.
Эксперт спрашивает, что участник сделал с парой сильно коррелированных признаков, — вопрос почти обязательный. Он просит назвать, какой признак из пары оставлен.
Шаг 4.3.3
Считаем связь признаков с целевой переменной отдельно, потому что это основа отбора. Для регрессии — корреляция Пирсона и Спирмена с целевой, для классификации — точечно-биссериальная корреляция или сравнение средних по классам с оценкой значимости (ttest_ind, а при нарушении нормальности — Mann-Whitney). Результаты сортируем по модулю и оформляем горизонтальной диаграммой: так сразу видно десятку признаков, которые несут основной сигнал.
Этот шаг напрямую кормит критерий «Выполнен отбор признаков, необходимых для обучения модели» на 5 баллов и одновременно позволяет ответить на частные вопросы работодателя: чаще всего они как раз про то, что сильнее всего связано с результатом. Диаграмма связи с целевой — ещё и один из самых убедительных рисунков в отчёте.
Для каждого признака есть коэффициент связи с целью и его значимость, список отсортирован, а на диаграмме подписаны значения. Отдельно отмечены признаки с нулевой связью — их кандидаты на удаление. Список отсортирован по модулю коэффициента.
Ошибка — считать корреляцию с категориальной целевой через Пирсона, получив бессмысленное число. Вторая — отбирать признаки только по связи с целью и не заметить, что два из них дублируют друг друга. Это стоит 5 баллов за отбор признаков.
Эксперт смотрит на диаграмму связи с целевой и просит объяснить два-три верхних признака содержательно. Он просит объяснить признаки не из верхушки списка.
Действие 4.4. Ответить на частные вопросы работодателя
Шаг 4.4.1
Читаем формулировку частных вопросов в задании и разбираем её на условия фильтрации. Каждое условие превращаем в отдельную маску: df[(df['регион'] == 'Республика Башкортостан') & (df['год'] == 2025) & (df['сумма'] > 0)]. Маски собираем по одной и печатаем число строк после каждой, чтобы видеть, какое условие отсекает больше всего. Итоговую выборку сохраняем в отдельную переменную и в файл, чтобы все последующие расчёты шли по одному и тому же подмножеству.
Критерий «Даны ответы на частные вопросы о характере данных» стоит 5 баллов, и он проверяется на соответствие вопроса и ответа: если в вопросе речь о конкретном сегменте, а расчёт сделан по всему набору, балл не ставится. Пошаговая печать числа строк — единственный способ поймать пустую выборку до того, как на ней будут посчитаны средние.
После каждого фильтра напечатано число строк, и оно уменьшается логично: сначала с 96 тысяч до 12, потом до 3, а не сразу до нуля. Итоговая выборка не пуста, а её размер сопоставим с ожидаемым по смыслу вопроса.
Ошибка — соединить все условия в одну строку и получить пустой результат из-за одного неверного значения в фильтре, а потом считать средние по пустому DataFrame и получать NaN. Вторая — забыть про регистр в строковых значениях и отфильтровать ноль записей.
Эксперт сверяет число строк в вашей выборке со своим контрольным расчётом: расхождение больше пары процентов вызывает вопросы. Вашу выборку он сверяет со своей по числу строк.
Шаг 4.4.2
Считаем группировки с полным набором агрегатов: df.groupby('категория').agg(среднее=('сумма','mean'), минимум=('сумма','min'), максимум=('сумма','max'), сумма=('сумма','sum'), количество=('сумма','size')). Названия столбцов задаём явно, чтобы таблица читалась без переименований. Сортируем по нужному показателю, печатаем и сохраняем в csv. Если группировок две, используем список в groupby и при необходимости разворачиваем результат через unstack для читаемости.
Пять агрегатов перечислены в самом задании, и каждый из них отвечает на свой тип вопроса: сумма показывает объём, среднее — типичный уровень, минимум и максимум — разброс, количество — надёжность среднего. Группа из трёх наблюдений с красивым средним — ловушка, и столбец «количество» её вскрывает.
В таблице ровно те столбцы, которые перечислены в задании, названия осмысленные, число строк соответствует числу уровней группировки. Для каждой группы указано количество наблюдений, и группы с количеством меньше пяти помечены.
Ошибка — посчитать только среднее и не посчитать количество, из-за чего выводы строятся на группах из двух записей. Вторая — оставить автоматические имена столбцов вида сумма_mean, которые в отчёте выглядят небрежно.
Эксперт ищет в отчёте таблицу группировки и проверяет, что в ней есть все пять агрегатов. Он смотрит, есть ли столбец с количеством наблюдений в группах.
Шаг 4.4.3
Оформляем ответы на вопросы связным текстом: сначала формулировка вопроса, затем число-ответ, затем короткое объяснение, откуда оно взялось, и ссылка на рисунок. Например: наибольшая средняя стоимость — в группе таких-то, 12 400 рублей при 340 наблюдениях, что видно на рисунке 7. Ответы нумеруем так же, как вопросы в задании, чтобы эксперт мог сверять построчно.
За этот пункт дают 5 баллов, и он оценочный: ценят не только цифру, но и то, что ответ действительно отвечает на вопрос. Нумерация по заданию экономит эксперту время и снижает риск, что ответ засчитают как отсутствующий, — на конкурсе это реальная потеря баллов.
На каждый вопрос задания есть отдельный абзац с числом, единицей измерения и ссылкой на график. Ни один вопрос не оставлен без ответа, даже если данных для него мало — тогда так и написано, с указанием причины.
Ошибка — ответить общими словами «в целом больше всего в крупных городах» без числа и без указания, по какой выборке считали. Вторая — ответить на пять вопросов из шести и потерять балл за пропущенный.
Эксперт сверяет ответы с заданием по номерам — это самая механическая часть оценки, и терять на ней баллы обидно. Он ищет ответ на каждый номер вопроса из задания.
Действие 4.5. Отобрать признаки и дополнить конвейер
Шаг 4.5.1
Отбираем признаки тремя способами и сравниваем результаты. Первый — фильтрация по связи с целевой и по мультиколлинеарности, то есть по тому, что уже посчитано. Второй — важности из модели: RandomForestRegressor или RandomForestClassifier, атрибут feature_importances_, отсортированный список. Третий — рекурсивное исключение признаков RFECV с кросс-валидацией, если время позволяет. Итоговый список формируем как пересечение двух первых подходов, а расхождения разбираем содержательно.
Критерий «Выполнен отбор признаков, которые необходимы для обучения модели» стоит 5 баллов, и он требует не просто списка, а обоснования: почему эти двенадцать, а не все двадцать пять. Сравнение методов как раз и даёт аргумент — признак, который попал в важности и не коррелирует с другими, почти наверняка несёт самостоятельный сигнал.
Есть итоговый список признаков с обоснованием по каждому исключённому столбцу: низкая важность, дублирование, утечка или техническое происхождение. Число оставленных признаков зафиксировано, и оно же использовано в конвейере.
Ошибка — отобрать признаки по важностям, обученным на всём наборе, включая валидацию: это утечка, и метрики в модуле С будут завышены. Вторая — исключить признак только потому, что у него низкая важность в одной модели, хотя он важен для другой.
Эксперт спрашивает, почему исключён конкретный признак, и ждёт содержательного ответа, а не ссылки на код. Он просит обосновать исключение, а не перечислить признаки.
Шаг 4.5.2
Дополняем конвейер шагом отбора: либо вставляем SelectFromModel(RandomForest..., threshold='median') как отдельный шаг Pipeline, либо передаём в конвейер уже отобранный список столбцов через ColumnTransformer. Первый вариант лучше, потому что отбор остаётся воспроизводимым и применяется автоматически к новым данным; второй проще и читаемее. В любом случае фиксируем, что отбор живёт внутри конвейера, а не в отдельной ячейке, которую забудут выполнить.
Критерий «Конвейер данных дополнен этапом отбора признаков» стоит 2 балла, и это самый простой способ их получить, если конвейер уже собран. Внутри конвейера отбор ещё и защищает от утечки: важности считаются только на обучающей части каждого фолда кросс-валидации.
Число столбцов на выходе конвейера уменьшилось по сравнению с предыдущей версией, и это видно в print(prep). Конвейер по-прежнему проходит fit на train и transform на валидации без ошибок, а список оставленных признаков совпадает с отобранным в предыдущем шаге.
Ошибка — обучить селектор на всём наборе и вставить в конвейер уже готовый список: формально шаг есть, фактически утечка осталась. Вторая — забыть обновить список числовых и категориальных столбцов после отбора и получить KeyError при fit.
Эксперт проверяет, что после отбора конвейер всё ещё работоспособен на новых данных. Он проверяет, что отбор стоит внутри конвейера, а не перед ним и не в отдельной ячейке.
Действие 4.6. Оформить отчёт по модулю В
Шаг 4.6.1
Собираем отчёт в структуру, повторяющую задание: постановка задачи и источники данных, структура набора и паспорт признаков, предобработка с обоснованием каждого решения, результаты исследования распределений и статистик, корреляционный анализ, ответы на частные вопросы с таблицами, отбор признаков, выводы. Каждый раздел начинается с одного абзаца о том, что и зачем сделано, затем таблицы и рисунки с подписями вида «Рисунок 3. Матрица корреляций».
Критерий «Оформлен отчёт о результатах исследований и вычислений» стоит 5 баллов, а «Отчёт качественно оформлен» — 3 оценочных. Структура по заданию нужна не для красоты: эксперт идёт по чек-листу критериев и в хорошо структурированном отчёте находит каждый пункт за секунды, а в сплошном тексте рискует не найти вовсе.
В отчёте присутствуют все разделы, у каждого рисунка и таблицы есть номер и подпись, а в тексте на них есть ссылки. Оглавление совпадает с фактическими заголовками, а объём соответствует объёму работы — не меньше восьми-десяти страниц с рисунками.
Ошибка — сдать отчёт из одних скриншотов кода без текста: оценочные 3 балла за качество оформления при этом не ставятся. Вторая — писать отчёт в последние пятнадцать минут и не успеть вставить половину рисунков.
Эксперт открывает отчёт первым делом и оценивает его структуру до чтения деталей. Он ищет раздел с выводами и проверяет, есть ли он в отчёте и полон ли.
Шаг 4.6.2
Доводим качество рисунков до конкурсного уровня: единый стиль (sns.set_theme(style='whitegrid')), размер шрифта не меньше 11, подписи осей с единицами измерения, заголовок у каждого графика, легенда там, где больше одной серии, отсутствие наложений текста. Сохраняем в PNG с dpi=150 или в SVG, если требуется векторный формат, и вставляем в отчёт в одном масштабе, чтобы шрифты не «плясали» от страницы к странице.
За качество диаграмм и графиков в модуле В предусмотрены отдельные 3 оценочных балла, и это те баллы, которые теряют чаще всего: графики построены, но без подписей осей, с обрезанными подписями и разным шрифтом. Единый стиль ещё и ускоряет работу: настроив тему один раз, дальше вы тратите секунды на каждый рисунок.
Каждый рисунок читается без пояснений: понятно, что по осям, в каких единицах, что означает цвет. Проверьте отчёт в режиме просмотра страницы — ни одна подпись не обрезана, ни один график не растянут и не сжат.
Ошибка — вставлять скриншоты графиков из ноутбука с тёмной темой и полями интерфейса: выглядит небрежно и снижает оценку. Вторая — сделать двадцать однотипных графиков вместо пяти информативных, из-за чего отчёт раздувается, а выводы теряются.
Эксперт оценивает оформление выборочно, открывая три-четыре рисунка наугад. Он смотрит, подписаны ли единицы измерения на осях и не обрезаны ли подписи.
Задача 5. Выбрать и обучить две модели, оценить качество и сохранить результатМодуль С · 30 баллов
Модуль С длится 1 час 40 минут и даёт 30 баллов — треть итоговой оценки. Задание специалистов требует не менее двух обученных моделей, оценки их качества и вывода о перспективах применения, причём выбор модели и выбор метрик обосновываются письменно (по 3 оценочных балла). Разделение данных стоит 5 баллов, обучение 5, вычисление метрик 5, оставшиеся баллы дают за вывод о качестве и сохранение модели в требуемом формате.
Действие 5.1. Выбрать и обосновать две модели
Шаг 5.1.1
Формулируем тип задачи по заданию одной фразой: регрессия, бинарная классификация, многоклассовая классификация или обучение без учителя. Проверяем это по целевой переменной: её тип, число уникальных значений, наличие порядка между классами. Если в задании требуются две модели, они должны решать одну и ту же задачу, иначе сравнивать их метрики нельзя. Вывод с долями классов записываем в отчёт.
Критерий «Выбрана модель для заданной задачи» стоит 5 баллов, и он ставится только тогда, когда тип задачи определён верно: модель регрессии на бинарной целевой переменной даёт бессмысленные числа, а trees-ансамбль на задаче с временной структурой без учёта времени — завышенные метрики.
В отчёте написано, какая задача решается и почему: например, целевая переменная принимает два значения с долями 68 и 32 процента, значит бинарная классификация с дисбалансом. Число классов и их доли подтверждены кодом.
Ошибка — принять числовую целевую переменную с тремя значениями за регрессию: модель будет предсказывать промежуточные значения, которых в природе не существует. Вторая — не заметить, что задача на самом деле про ранжирование или про обнаружение аномалий.
Эксперт спрашивает, как участник определил тип задачи, и ждёт ссылки на распределение целевой переменной. Он просит назвать доли классов, а не только тип задачи.
Шаг 5.1.2
Выбираем две модели с разной природой, чтобы сравнение было содержательным. Первая — интерпретируемая базовая: LinearRegression или Ridge для регрессии, LogisticRegression для классификации; её коэффициенты можно объяснить эксперту. Вторая — ансамблевая: RandomForestRegressor или RandomForestClassifier, а при достаточном времени — GradientBoosting или HistGradientBoosting. Стартовые гиперпараметры берём разумные: для леса n_estimators=300 и random_state=42, глубину позже подберём.
Требование «не менее двух моделей» прямо записано в задании, и балл за обучение (5) ставится за обе. Разная природа моделей нужна для вывода: если линейная модель и лес дают близкое качество, значит зависимость в данных в основном линейная, и это сильный содержательный вывод; если лес заметно лучше, в данных есть нелинейности и взаимодействия.
Обе модели созданы и напечатаны в ноутбуке до обучения, их параметры зафиксированы, а имена переменных отражают тип модели. В отчёте указано, какие именно модели выбраны, с полными названиями классов.
Ошибка — взять две почти одинаковые модели, например RandomForest и ExtraTrees, и потом не суметь объяснить, зачем их две. Вторая — сразу строить сложный бустинг без базовой модели: тогда не с чем сравнить и нечего защищать.
Эксперт смотрит на список моделей и на их стартовые параметры: наличие базовой модели — признак методической грамотности. Он спрашивает, чем вторая модель отличается по природе.
Шаг 5.1.3
Пишем обоснование выбора моделей словами, по абзацу на каждую. Для линейной модели: почему она подходит — интерпретируемость, устойчивость на малых выборках, наличие линейных связей по корреляционному анализу. Для ансамбля: способность ловить нелинейности и взаимодействия, устойчивость к масштабу и к выбросам, но меньшая интерпретируемость. Указываем и ограничения: чувствительность линейной модели к выбросам, склонность леса к переобучению при большой глубине.
Критерий «Выбор модели обоснован» — 3 оценочных балла, и они ставятся за аргументацию, а не за название алгоритма. Обоснование должно опираться на результаты модуля В: на корреляции, на распределения, на число наблюдений и признаков — так видно, что выбор сделан по данным, а не по привычке.
В отчёте есть раздел «Обоснование выбора моделей» объёмом не меньше половины страницы, где каждая модель связана с конкретным наблюдением из анализа данных. Упомянуты и ограничения каждой модели. На каждую модель — абзац с числами из анализа.
Ошибка — написать «выбрал RandomForest, потому что он даёт лучшее качество» до того, как модели обучены: это утверждение без доказательства, и оценочные баллы за него не ставятся. Вторая — обосновать выбор только популярностью алгоритма.
Эксперт читает этот раздел и задаёт вопрос «почему не наоборот?» — ответ на него и есть проверка обоснования. Ответ он сверяет с результатами корреляционного анализа.
Действие 5.2. Разделить данные на обучающую и валидационную части
Шаг 5.2.1
Делим данные один раз и сохраняем индексы: train_test_split(X, y, test_size=0.2, random_state=42, stratify=y) для классификации и без stratify для регрессии. При временной структуре данных используем не случайное разделение, а разрез по дате: обучение на раннем периоде, валидация на позднем, иначе модель увидит будущее. Печатаем размеры обеих частей и доли классов в каждой — они должны совпадать с точностью до десятых.
Критерий «Данные разделены на два набора — для обучения и валидации» стоит 5 баллов, и стратификация — то, за что эти баллы реально дают: без неё при дисбалансе 95 на 5 в валидацию может попасть три объекта меньшинства, и метрики станут случайными. Разделение до всякой подготовки данных — ещё и защита от утечки.
Валидационная часть составляет ровно 20 процентов, доли классов в train и valid отличаются не больше чем на 1–2 процентных пункта, а индексы сохранены в переменных, чтобы к ним можно было вернуться. Пересечение индексов пустое.
Ошибка — делить данные после масштабирования и заполнения пропусков: тогда в train попала статистика валидации. Вторая — менять random_state между моделями, из-за чего сравнение становится нечестным. Тогда сравнение моделей становится нечестным.
Эксперт проверяет, что разделение выполнено до конвейера, а не после подготовки признаков. Он смотрит, до или после конвейера сделано разделение данных.
Шаг 5.2.2
Проверяем отсутствие утечки явно, а не на словах: для каждого преобразования с состоянием убеждаемся, что fit вызван только на X_train. Практический тест — обучить конвейер на train, получить метрику на valid, затем перемешать целевую переменную в train и обучить снова: при честной схеме качество на valid упадёт до уровня случайного. Если после перемешивания метрика осталась высокой, где-то есть утечка, чаще всего через идентификатор или через признак, посчитанный по всей выборке.
Тест с перемешиванием целевой переменной — самый быстрый способ найти утечку, и он занимает две минуты. На конкурсе это спасает от ситуации, когда модель показывает 0,98 и эксперт на защите находит в признаках номер договора, по которому напрямую определяется результат.
После перемешивания метрика на валидации падает до уровня случайного предсказания: для классификации accuracy около доли большего класса, для регрессии R2 около нуля или ниже. До перемешивания метрика осмысленно выше.
Ошибка — оставить в признаках идентификатор записи или дату создания, по которым восстанавливается целевая переменная. Вторая — посчитать целевое кодирование категорий по всему набору до разделения. Утечка остаётся, а метрика завышается.
Эксперт ищет в списке признаков технические столбцы и спрашивает про них прямо: это типовой способ поймать утечку. Он спрашивает, почему в признаках остался идентификатор.
Действие 5.3. Обучить обе модели
Шаг 5.3.1
Обучаем базовую модель на подготовленных данных: pipe_lin.fit(X_train, y_train), затем предсказания y_pred = pipe_lin.predict(X_valid). Фиксируем время обучения через time.perf_counter(): для отчёта полезно знать, что линейная модель учится доли секунды. Сразу считаем метрики на train и на valid: расхождение между ними показывает переобучение или недообучение, и это первое, что смотрят эксперты.
Критерий «Модель обучена» стоит 5 баллов, но обучают её обычно формально: без метрик на train сравнение с валидацией невозможно, а значит невозможно и вывод о качестве. Время обучения пригодится в выводе о перспективах применения — модель, которая учится час, в промышленной эксплуатации требует отдельного обоснования.
Базовая модель обучена, предсказания получены на обоих наборах, метрики посчитаны и напечатаны. Время обучения записано. Модель не выдаёт ошибок на валидации, а предсказания имеют правильный тип и диапазон.
Ошибка — обучить модель прямо на полном датафрейме, потому что «так точнее»: тогда валидационных метрик не существует, и 5 баллов за разделение обесцениваются. Вторая — не считать метрику на train и не увидеть, что линейная модель недообучена.
Эксперт смотрит, есть ли в ноутбуке обе метрики — на train и на valid. Он просит назвать оба числа вслух, без подсказки, и объяснить, откуда такой разрыв.
Шаг 5.3.2
Обучаем вторую модель и добавляем кросс-валидацию: cross_val_score(pipe_rf, X_train, y_train, cv=5, scoring='neg_root_mean_squared_error' или 'f1_macro') даёт пять значений, по которым видно разброс. Среднее и стандартное отклонение по фолдам печатаем и указываем в отчёте: если отклонение больше пяти процентов от среднего, модель нестабильна и полагаться на одно разбиение нельзя.
Кросс-валидация — аргумент в выводе о качестве: одна цифра на одной валидации может быть случайной, а пять фолдов показывают устойчивость. Кроме того, разброс по фолдам подсказывает, не переобучен ли ансамбль и не пора ли ограничить глубину деревьев.
Пять значений метрики напечатаны, среднее и стандартное отклонение посчитаны. Ансамбль обучен на полном train и даёт предсказания на valid без ошибок. Время обучения зафиксировано: для леса оно на порядок больше линейной модели.
Ошибка — делать кросс-валидацию на объединённых train и valid и потом всё равно докладывать метрику на valid: это двойное использование валидации. Вторая — использовать cv=5 при маленьких классах, когда в некоторые фолды не попадает ни одного объекта меньшинства.
Эксперт спрашивает про разброс метрик по фолдам: наличие стандартного отклонения в отчёте — признак зрелости. Он просит сравнить разброс по фолдам с разницей моделей.
Шаг 5.3.3
Если время позволяет, делаем короткий подбор гиперпараметров для ансамбля через GridSearchCV по сетке из трёх-четырёх комбинаций: n_estimators из {200, 400} и max_depth из {None, 12}, cv=3, scoring той же метрикой. Сетку держим маленькой осознанно: за десять минут можно перебрать сотню комбинаций и не успеть оформить отчёт, а выигрыш обычно составляет доли процента.
Подбор гиперпараметров — не обязательный пункт задания, но он усиливает обоснование выбора модели и показывает понимание компромисса между качеством и временем. Главное правило: подбор идёт только на train, валидация остаётся нетронутой до финальной оценки.
Лучшие параметры найдены и напечатаны, качество после подбора не хуже исходного, а валидация всё ещё не использовалась при поиске. В отчёте указано, сколько комбинаций перебрано и сколько времени это заняло.
Ошибка — подбирать гиперпараметры по валидационной выборке и потом докладывать её метрику как честную оценку: она завышена, и на защите это ловится вопросом «а как вы выбирали параметры?». Вторая — запустить слишком большую сетку и не дождаться результата.
Эксперт проверяет, на какой выборке шёл подбор, — это стандартный вопрос по методике. Ответ «подбирал по валидации» он считает грубой ошибкой методики.
Действие 5.4. Выбрать метрики, посчитать и сравнить
Шаг 5.4.1
Выбираем метрики под задачу и обосновываем выбор. Для регрессии: MAE — в единицах целевой переменной и устойчива к выбросам, RMSE — штрафует крупные ошибки, R2 — доля объяснённой дисперсии; докладываем все три, потому что они отвечают на разные вопросы. Для классификации при дисбалансе: precision, recall, F1 и ROC-AUC, а accuracy указываем только как справочную. Пишем, какая метрика главная и почему именно она.
Критерий «Выбраны метрики для оценки качества модели, выбор метрик обоснован» — 3 оценочных балла, и они напрямую зависят от баланса классов и от цены ошибки в прикладной задаче. Если в задании речь о пропуске клиента, важнее recall; если о ложном срабатывании — precision. Это и есть обоснование.
В отчёте названы метрики, для каждой указано, что она измеряет и почему включена. Указана главная метрика и направление улучшения. Ни одна метрика не выбрана «по умолчанию» — для accuracy это должно быть явно проговорено.
Ошибка — доложить только accuracy при дисбалансе 95 на 5: модель, предсказывающая всегда majority, даёт 0,95 и выглядит отличной, хотя не различает классы вообще. Вторая — выбрать метрику после того, как увидели результаты, подогнав обоснование под лучшую цифру.
Эксперт спрашивает, почему главная метрика именно эта, и проверяет, связан ли ответ с постановкой задачи. Он просит назвать цену ложной ошибки в этой задаче.
Шаг 5.4.2
Считаем метрики для обеих моделей на валидации и сводим в таблицу: строки — модели, столбцы — метрики, плюс время обучения. Для классификации дополнительно печатаем classification_report и матрицу ошибок через ConfusionMatrixDisplay, для регрессии — график «предсказано против факта» и гистограмму остатков. Таблица сравнения — центральный артефакт модуля С, её показывают экспертам первой.
Критерий «Вычислены метрики качества модели» стоит 5 баллов, и таблица сравнения — самый удобный для эксперта способ убедиться, что метрики посчитаны для обеих моделей. Матрица ошибок и остатки нужны для содержательного вывода: они показывают, где именно модель ошибается, а не только насколько.
Таблица заполнена по всем моделям и всем метрикам, значения согласуются с ранее напечатанными, а матрица ошибок и остатки построены. Сумма по матрице ошибок равна числу объектов в валидации — это проверка, что ничего не потерялось.
Ошибка — посчитать метрики только для лучшей модели, а вторую оставить без цифр: сравнения нет, и балл за вычисление метрик снимается частично. Вторая — перепутать порядок аргументов в метрике и получить precision и recall наоборот.
Эксперт сверяет значения в таблице с теми, что выдаёт код при повторном прогоне. Он открывает матрицу ошибок и спрашивает, какой класс модель путает чаще.
Шаг 5.4.3
Проверяем модели на переобучение: сравниваем метрику на train и на valid, для леса дополнительно смотрим, как качество меняется с ростом числа деревьев. Если разрыв больше 10–15 процентов, ограничиваем глубину (max_depth=12), увеличиваем min_samples_leaf до 5–10 или уменьшаем число признаков в сплите. Для линейной модели признак переобучения — огромные по модулю коэффициенты, что лечится регуляризацией Ridge или Lasso.
Разрыв между train и valid — то, что эксперт проверяет первым делом, и завышенная метрика на train без комментария читается как непонимание методики. Умение показать, что модель отрегулирована, усиливает вывод о качестве и влияет на оценочные баллы за обоснование.
Разрыв между train и valid не превышает 10 процентов, и это записано числом в отчёте. Для леса построена кривая зависимости качества от числа деревьев или от глубины, и на ней видно выход на плато. Разрыв указан числом, а не словом «небольшой».
Ошибка — оставить лес с неограниченной глубиной, получить на train 0,99 и на valid 0,74 и всё равно объявить модель хорошей. Вторая — «лечить» переобучение удалением половины признаков без проверки, что качество не упало.
Эксперт смотрит на два числа рядом — train и valid — и просит объяснить разрыв. Разрыв он просит объяснить словами, без ссылки на код и без «так вышло».
Действие 5.5. Сделать вывод, сохранить модель и защитить результат
Шаг 5.5.1
Формулируем вывод о качестве и о перспективах применения: какая модель лучше по главной метрике, насколько она лучше базовой, какие ошибки преобладают, при каких условиях модель пригодна. Обязательно переводим метрику в прикладной язык: MAE 1200 рублей означает, что типичная ошибка прогноза — около 1200 рублей, и это сопоставимо с прибылью на клиента или нет. Указываем ограничения: на каких сегментах модель хуже и почему.
Оставшиеся баллы модуля С дают за вывод о качестве обученной модели, и это самый содержательный критерий: цифра без интерпретации не отвечает на вопрос о целесообразности применения. Сравнение с базовой моделью здесь обязательно — иначе непонятно, стоила ли сложность ансамбля выигрыша в качестве.
В выводе есть три элемента: сравнение моделей по главной метрике с числами, перевод метрики в единицы предметной области, перечень ограничений и условий применения. Утверждения подкреплены цифрами из таблицы сравнения.
Ошибка — написать «модель показала хорошее качество и может использоваться» без чисел и без границ применимости. Вторая — объявить лучшей модель с метрикой выше на сотые доли, хотя разброс по фолдам больше этого различия.
Эксперт задаёт вопрос «что бизнес получит от этой модели» — и оценивает ответ по конкретности. Он просит перевести метрику в рубли, часы или штуки продукции.
Шаг 5.5.2
Сохраняем лучшую модель в требуемом формате: joblib.dump(best_pipe, f'model_[номер].joblib') — сохраняем весь конвейер, а не только оценщик, чтобы новые данные проходили ту же подготовку. Сразу проверяем загрузку в новой сессии: model = joblib.load(path), предсказание на трёх сырых строках и сравнение с предсказанием до сохранения. Если в задании указан pickle, используем pickle.dump с protocol=5, но конвейер сохраняем в любом случае.
Сохранение модели — отдельное требование задания, и без него работа считается несданной, даже если метрики хорошие. Сохранение конвейера вместо оценщика принципиально: голый RandomForest на входе ожидает уже закодированные признаки, и при загрузке в продакшене его нельзя применить к сырым данным.
Файл модели существует, его размер ненулевой, загрузка в отдельной сессии проходит без ошибок, а предсказания совпадают с исходными до третьего знака. Для классификации дополнительно проверено, что predict_proba возвращает сумму вероятностей, равную единице.
Ошибка — сохранить только оценщик и потерять преобразования: при загрузке модель падает на сырых данных или выдаёт бессмысленные числа. Вторая — сохранить модель, обученную на всём наборе, и не суметь воспроизвести метрики из отчёта.
Эксперт может попросить загрузить файл при нём: это проверка не формальности, а работоспособности артефакта. Он проверяет, сохранён весь конвейер, а не только оценщик.
Шаг 5.5.3
Готовим короткую защиту на три-четыре минуты: постановка задачи в одном предложении, что сделано по модулям, главная таблица сравнения моделей, вывод и ограничения. Держим под рукой открытыми три окна — ноутбук с ключевыми ячейками, отчёт и папку с артефактами, — чтобы отвечать на вопросы без поиска. Отдельно готовим ответ на вопрос «почему не наоборот» про выбор модели и на вопрос про утечку.
Защита результатов входит в задание отдельным пунктом, и она влияет на оценочные баллы: связный рассказ с числами убеждает эксперта, что участник понимает свою работу, а пересказ слайдов без цифр — наоборот. Три-четыре минуты — это примерно 400–500 слов, поэтому каждый тезис должен нести число или решение.
Рассказ укладывается в три минуты без спешки, все артефакты открываются по первому требованию, а на два типовых вопроса есть заготовленные ответы с цифрами. Проверьте это репетицией с таймером. Репетиция с таймером показывает, укладываетесь ли вы.
Ошибка — начать защиту с описания библиотек и версий, потратив половину времени на то, что эксперты и так видят в отчёте. Вторая — не уметь открыть сохранённую модель и показать её работу. Ответ без цифр он не принимает.
Эксперт слушает вывод и задаёт один-два вопроса по методике: именно здесь видно, кто понимал, что делал. Он задаёт вопрос про ограничения модели и условия отказа.